

如今,AI PC和工作站已经能够运行千亿参数级别的模型,“模型能不能在本地跑起来”已经不再是难题,越来越多的用户开始把一部分AI任务从云端搬回自己的机器上。
但能跑起来,并不等于跑得好。本地生成的Token在质量上与云端仍有明显差距,哪些任务留在云端、哪些放到本地,不少企业说不清楚;到了采购环节,面对算力、显存、内存、存储一长串参数,用户也很难判断究竟哪一项在决定使用体验。
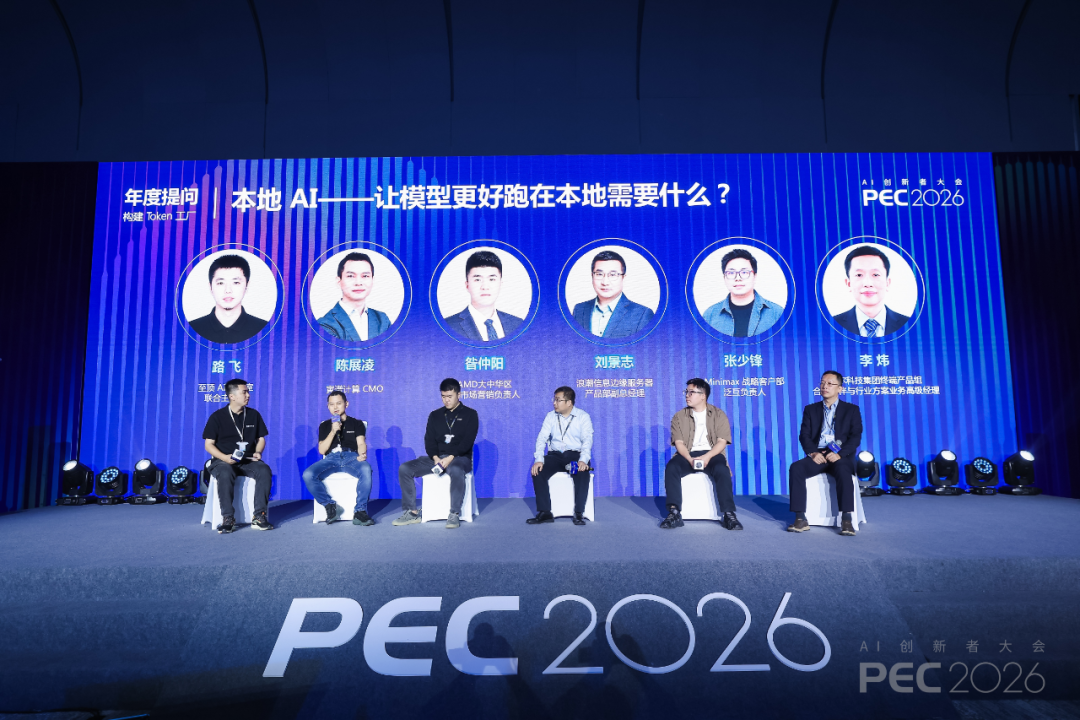
9月12日,在第三届AI创新者大会暨PEC 2026的年度对话环节,聚焦“让模型更好跑在本地需要什么”主题,寅谱计算CMO陈展凌、AMD大中华区AI市场营销负责人昝仲阳、浪潮信息边缘服务器产品部副总经理刘景志、MiniMax战略客户部泛互负责人张少锋,以及戴尔科技集团终端产品组合作伙伴与行业方案业务高级经理李炜,围绕本地AI“谁在用、怎么分工、如何选型”展开了讨论。
数据不出域、成本不失控
在陈展凌看来,AI越深入工作流,几个问题就越突出。排在最前面的,是数据隐私与合规问题,研发数据、生产数据,以及财务金融类数据,在很多场景下根本无法上传,数据出不去,推理就只能放在本地。
成本是第二笔账。按照陈展凌的说法,如果企业跑的是长对话或长文本工作流,每天消耗十万甚至上百万Token,那么云端调用的费用会变成“黑洞”,但放到本地则相对可控。
再往下是响应的稳定性和时延。AI嵌入业务流程之后,关键往往不在于模型有多聪明,而在于需要它的时候,能否在可接受的时延内稳定地调用起来。研发、咨询等知识密集型的生产力平台,创业公司的研发试错环境,以及门店管理、生产检测这类数据在本地产生、也在本地消费的场景,都更适合放在端侧。
对于企业级场景,刘景志表示,企业客户在本地跑模型,最主要的驱动力是把AI转化为生产力,工厂产线、智慧门店等业务。这些业务既要求数据在本地消化,也要求系统稳定运行。很多企业需要7×24小时不间断运行,还要能远程管理、与云端协同,这也决定了硬件在电源、管理等方面都有专门要求,PC与企业级小型服务器在设计上仍有不少差别。
需求变了,用户关注的指标也在跟着变。昝仲阳注意到,用户的关注点正在从模型能不能跑起来,转向本地模型能否有效完成任务、能否用更短的时间完成,CPU与GPU之间的协同也因此变得更加重要。
在他看来,本地模型正在变得聪明,以锐龙AI Max+ 395为代表的平台,凭借统一内存架构能够同时容纳多个优秀模型,显存可以按需动态分配。

把负载放在“对的位置”
既然模型已经能跑在本地,那云端还要不要用,又该怎么用?
张少锋分享了一个反直觉的现象。他指出,过去选择私有化部署的,通常是技术能力更强的大企业,但自M3开源以来,MiniMax观察到小公司私有化部署的意愿反而更强。一方面,M3的规模让许多中小公司甚至个人具备了部署条件,如果手里已有算力,本地部署能够降低整体使用成本;另一方面,M3只开源了一个版本,市面上却已衍生出超过200个量化版本,客户很容易找到与自身业务更匹配的版本。
大公司的情况恰好相反。据张少锋介绍,大公司对吞吐、并发等方面要求很高,私有部署未必能完全满足。同时,因为其用量大、议价能力强,调用API反而可以进一步压低成本。业务诉求同样影响选择,部署完成后要把服务再售卖出去的公司不可能选API,而在很多大公司内部,模型只是庞大业务体系中的一环,自建诉求并不强烈。
这些本地模型谁会更快用起来?刘景志的判断同样是中小企业。他指出,大企业的工作流程已经非常稳定,要把AI嵌进全部流程,周期不会短;中小企业不需要改动太多流程,用AI解决一个具体问题,反而最受欢迎。
他观察到的几类典型客户中,一类是OPC(一人公司),一个人或几个人的团队,核心数据就是生产力,不可能交到外面;另一类是自上而下由老板推动,老板做决策用的经营数据不会放到外部,“老板机”由此成为典型案例。
落到具体决策上,李炜认为,很多企业在云与本地之间犹豫,根源往往是缺少一套清晰的AI策略。戴尔鼓励用户把AI负载放在最合适的位置,其中Token成本排在首位,过去一年Token单价虽有下降,但实际消耗量增长到原来的约10倍,整体支出反而在上升;此外还要看响应速度,以及数据能否流出办公环境。
他给出的梳理办法是看AI的使用方式。如果是复杂工作、长期或周期性使用,会持续产生Token消耗,本地处理最合适;如果是短期内需要大量调用的突发性任务,云端的弹性优势更明显。收集公开资料、跟踪科技资讯这类工作交给云端没有问题,而财务数据整理、医院病历梳理、核心代码库校验等涉及敏感数据和知识产权的任务,放在本地或企业数据中心可能是更优解。

选型先看“装得下”,再看“跑得顺”
分工想清楚之后,落到采购上,用户该盯住哪些指标?
陈展凌先抛出一个观点,他认为算力通常被视为关键指标,但并非决定因素,显存大小才决定本地能跑多大的模型。按照他的估算,运行7B模型最少需要16GB显存,想跑得顺畅大约需要24GB,可7B模型与云端API差距明显;如果想跑70B以上的模型,至少需要64GB,而当下内存涨价非常厉害,端侧设备的成本压力随之加大。
面对显存不够的问题,寅谱计算选择从存储上想办法。陈展凌介绍,寅谱做的面向推理优化的SSD方案。MoE(混合专家)模型的专家并非同时激活,寅谱区分热数据与激活模式,在GPU需要之前提前把相关权重和专家信息送入GPU,既不降低量化精度,也不降低输出速度。
推理是在存储与计算之间反复搬运权重和专家数据,所以显存带宽同样关键。在陈展凌看来,云端资源密集,考虑的是如何把利用率拉满,端侧资源有限,效果取决于CPU、显存、存储、网络的协同效率。他还提醒,要关注开源社区的活跃度、模型更新速度和驱动支持,如果只为追求性能去改代码、改框架,后续会浪费大量精力。
芯片层面,昝仲阳更看重的是数据主权。在他看来,数据留在端侧不仅是对于数据和隐私的保护,更是长期对于经验和价值差异化的积累。基于锐龙AI Max+ 395处理器的智能体主机具备各种形态可以适用于各种不同的智能体场景,并且部分端测主流的最新开源模型,推理速度可达每秒50~60个Token,体验已接近常用的云端大模型。
李炜则从企业的采购误区谈起。
第一个误区是模型越大越好,他以业内一款热门的27B模型为例,该模型在代码处理上表现优秀,在许多榜单上名列前茅,原因在于其专门针对编程做了训练,而动辄万亿参数的通用模型未必在此占优。所以企业要先明确自己想做什么,模型小一些,能部署的设备更多,并发和响应也更好。
另一个误区是混淆训练与推理。早年间,企业希望把自有数据训练进模型,但模型迭代太快,新模型一出就要重训。如今,更多企业把数据与模型分离,通过知识库与模型结合的方式使用,算力主要花在推理上,而推理强调响应速度和并发,对显存和带宽的整体需求远低于训练。
量化精度的选择也容易被忽视。李炜打了个比方,摄影师交付的是精度最高的原图,但照片用在户外广告还是桌面摆件,对精度的要求并不相同。对比来看,模型厂商往往在发布了FP16原始模型的同时也提供了量化版本,用户要按场景选择。
归根结底,本地Token与云端的质量差距,并不能只靠堆算力来弥补。存储侧的软扩充让更大的模型装得下,统一内存让多个模型同时跑得起来,合适的量化精度和一条官方API通路,则决定了用户用到的是不是模型真实的能力。
对于准备采购本地AI设备的企业而言,先想清楚任务放在哪里,再去看显存、带宽和生态,或许比盯着算力参数更实际。

 VIP复盘网
