

AI算力的竞争持续深化,散热系统的重要性正在凸显,一组数据可以说明问题:英伟达H100的TDP约为700W,到B200/B300已突破1000W,而面向2026年的Rubin平台单GPU功耗预计达到2300W,2027年Rubin Ultra将进一步升至4000W,对应超节点功率直接向MW级迈进。
与此同时,单机柜功率密度正从风冷物理极限的40-60kW,向300kW乃至1MW跃升——散热能力已经事实上成为算力部署的前置约束。
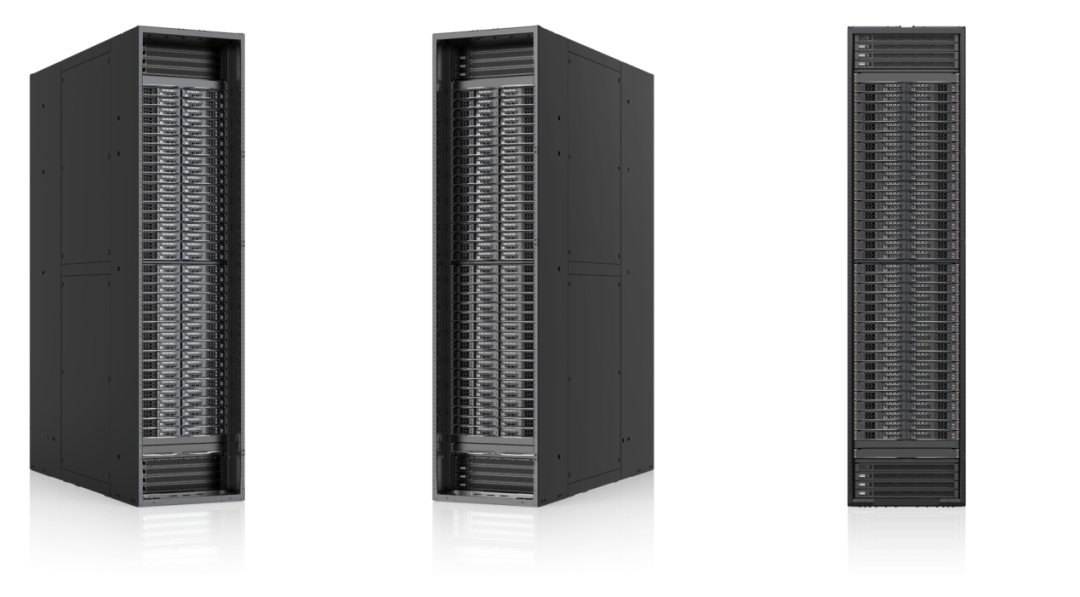
正是在这个节点上,宁畅信息于9月15日正式推出全球首个MW级单相冷板全液冷超节点方案,把单柜散热能力直接做到了1MW,为下一代高功耗AI芯片和高密度算力集群提供了一条新的工程路径。
从“可选“ 到 ”必选“:液冷如何被AI芯片逼成刚需
液冷散热在AI芯片中的渗透率已从2025年的约33%上升至2026 年的53%,2027年有望逼近60%;中国市场同样在加速——据中商产业研究院数据,中国液冷服务器渗透率从2021年不足3%提升至2025年的20%,2026年预计跃升至37%,2027年有望突破50%临界点。
市场规模方面,2025年中国液冷数据中心市场规模达159.8亿元,同比增长45.2%,预计2026年达232.5亿元,2028年突破470亿元;另外2026年全球智算中心液冷市场规模将达1147亿元,同比增长273%,被称为”液冷放量元年“。
驱动这一切的,是超节点形态的崛起。以英伟达GB200 NVL72为代表,单机柜集成72颗GPU,整柜功耗约120-135kW(据NVIDIA及Supermicro公开参数),且强制液冷;而到了Rubin平台,单机柜功耗进一步攀升至约225kW。当整柜功耗逼近MW级临界点,传统以单台服务器为设计对象的冷板液冷方案,在计算与交换节点同时高负载运行时,散热架构已经触及能力上限——这正是宁畅此次方案的切入逻辑:液冷需要从“芯片级散热” 升级为“系统级解热”。
单柜1MW、单芯片5000W:三维度刷新解热上限
宁畅这套方案的价值,可以拆成芯片、节点、机柜三个维度来看。
机柜层面,单柜总散热能力达到1MW,把过去通常需要多柜组合才能实现的MW级散热能力,集中整合进一台机柜。对机房而言,这意味着在有限空间内部署更多算力,同时减少机柜扩展带来的配电、管路和土建投入——在土地和电力都日益稀缺的当下,这是实打实的成本账。
节点层面,1U单节点解热能力达到28kW,属于目前业界公开方案中的最高水平,可满足高密度节点持续运行的散热需求。
芯片层面,方案在全球率先迈向单芯片5000W散热承载,为下一代AI芯片功耗继续提升预留了充足的技术冗余。考虑到英伟达Rubin Ultra在2027年可能达到4000W TDP,这一冗余并非空转,而是提前卡位。
补上交换节点盲区:全液冷才是一套完整方案
如果说“解热上限” 是参数竞赛,那么 “覆盖范围” 则是更隐蔽的行业短板。
行业现有液冷方案大多聚焦计算节点,交换节点受板内器件、光模块及液路工况限制,很少被纳入液冷覆盖 —— 这构成了高密度集群的散热盲区:算力节点“泡”在冷液里,交换节点却仍在 “裸奔”,整柜散热能力被短板效应拖累。
宁畅的应对是国内率先推出的正交全液冷与全盲插方案,将计算节点、交换节点、供电模块及Busbar母线全部纳入液冷覆盖。其中,计算与交换节点依靠两级Manifold实现全盲插,设备推入机柜即可自动完成水路对接,免去现场人工接管工序;同时水路与供电区域物理隔离,降低漏液对供电部件的风险。这套设计兼顾了散热覆盖的完整性和运维的便利性——对大规模智算集群的交付和后期维护而言,这两点同样决定方案能否真正落地。
液冷不只是散热,更是Token成本的算术题
对智算中心运营者来说,散热直接决定算力的 “有效产出”。芯片过热降频意味着真金白银的算力损耗,冷却液循环阻力则直接反映在水泵耗电上。宁畅方案通过提高各节点间的供液均匀度,消除局部热点,减少过热降频造成的算力损失,同时降低供液需求和水泵电力消耗。
更进一步看,大模型运营者的单位Token成本,从来不只是芯片采购,还包括机房、配电、散热及运维的全链路投入。单柜 MW 级散热带来的单位面积算力密度提升,意味着用更少的机柜和配套资源支撑同等算力,这是千亿级液冷市场从“配套工程”向“核心基础设施”的转身。
全球AI竞争正从芯片性能延伸至能源利用和系统效率,散热能力已成为高密度智算集群规模部署的重要支撑。宁畅此次发布的意义,在于为冷板液冷进入MW级应用提供了可落地的工程参考,也增强了国内面向下一代AI芯片的自主散热技术供给能力。

 VIP复盘网
