

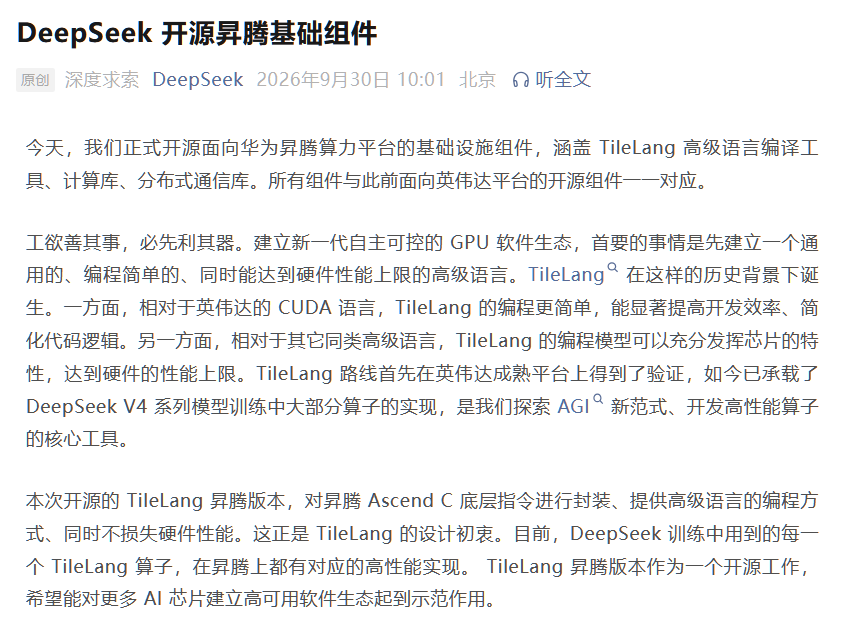
9月30日,DeepSeek一次性开源六个面向昇腾平台的基础设施组件,分别是TileLang、DeepGEMM-Ascend、DeepEP-Ascend、TileKernels、FlashMLA、DeepSelect,与此前英伟达平台的组件严格一一对应。官方的表述很平静,同样的API,同样的项目名,同样的使用方式,只是换了一块芯片。
但如果只把它读成一次开源,就错过了真正值得注意的东西。这件事的本质,是AI软件栈的定义权正在从硬件厂商手里,转移到模型厂商手里。
抛开发布会的修辞,这批组件公布的实测数据值得逐字读。
DeepGEMM-Ascend的BF16密集矩阵乘法算力利用率,测试环境为昇腾950DT与CANN 9.20,FP8场景约99.5%。这是为数不多由第三方算子库把芯片算力推到接近峰值的公开案例。
DeepEP-Ascend在EP8规模下的dispatch带宽。官方口径是,EP规模不超过32时,dispatch带宽可达物理载荷上限的90%到95%。通信这个大规模MoE训练里最昂贵的环节,被压到了硬件天花板附近。
双方共同推进的昇腾950超节点方案。华为提供了联合定义的SuperPoD Flex与UBL128组网,128卡3.2Tbps单层交换的Scale-up网络,可扩展至256K卡两层交换的Scale-out网络。
三个数字分别对应算、联、扩,即单芯片算力兑现、卡间通信效率、集群横向扩展,这恰恰是评估一套AI算力平台能否承载前沿模型训练的三道门槛。
数据本身不是宣传话术能解释的,DeepEP-Ascend的README里甚至保留了诚实的边界说明,EP128场景下combine带宽受本地归约开销和URMA的HBM争用影响仍在优化,华为计划通过固件升级缓解。
真正值得分析的是这个成绩是怎么拿到的。
过去十年,英伟达的护城河被习惯性地概括为CUDA生态。
于是几乎所有挑战者的叙事都是我们也有一个类似的工具链,结果无一成功,因为开发者迁移的是一整套习惯、文档、调试经验和社区知识,而不是几行API。
DeepSeek走了一条不同的路。
TileLang不是昇腾的专有语言,而是一个跨平台的领域专用语言,同一套Python API,运行时自动在英伟达GPU和昇腾NPU之间选择后端。
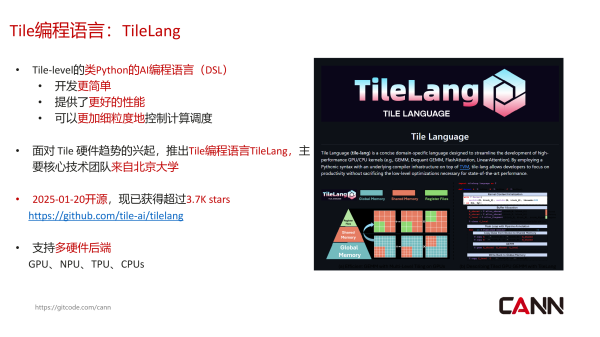
它在英伟达平台上先被充分验证,DeepSeek V4系列训练的绝大多数算子都基于TileLang实现,然后以新增后端的方式落到昇腾上。开发者不需要从CUDA迁移到某个新东西,他们留在原地,只是硬件选项多了一个。
换句话说,DeepSeek没有把CUDA当成要攻克的堡垒,而是把它当成要架空的地基。当模型厂商自己最核心的生产工具天然跨平台时,绑定英伟达就不再是模型层的理性默认选项。
这一次开源中专门新建的两个仓库,DeepGEMM-Ascend与DeepEP-Ascend,API与英伟达版完全兼容,同一套代码在两个平台间切换,就是这个意图的直接体现。
官方明确表示希望这次开源能对更多AI芯片建立高可用软件生态起到示范作用,这句话不是客套。TileLang的后端是开放的,今天接的是昇腾,明天理论上可以接任何愿意开放底层指令集的芯片。
比软件移植更值得注意的是协作方式。
这次适配不是DeepSeek拿到硬件后单方面做适配。根据双方披露的信息,华为开放了Ascend C编程接口与PTO ISA底层指令体系,提供了联合定义的UBL128组网方案,并把联合创新成果放进CANN社区开源。
DeepSeek则把训练用到的每一个TileLang算子都在昇腾上做了高性能实现,并开发出覆盖EP、CP、PP、FSDP多种并行模式的通信库。
这是一种新的产业分工雏形,芯片厂商提供足够开放的底层,模型厂商负责把性能榨到硬件上限。
模型团队的需求,即什么样的并行模式、什么样的通信粒度、多大的超节点,前置到了芯片与组网方案的定义阶段。芯片不再先造好再求生态,而是和模型共同演化。用双方自己的话说,这是芯模协同、双向奔赴。
这个模式为什么重要?
因为它回答了一个产业级疑问,国产算力缺的究竟是芯片,还是把芯片用起来的人。99.8%的利用率说明,在深度协同的条件下,后者是可以被补齐的。
客观地说,这仍然是起步而非终点。
其一,部分能力尚在早期。DeepEP-Ascend的Bucket集合通信、专家负载均衡仍在开发,满带宽运行依赖的Atlas 850E商用版HDK预计10月中旬才开放申请,当前数据基于PoC版本测得,早期用户的实测带宽可能低于文档数值。这是固件差异,不是软件问题,但用户的实际体验确实会打折扣。
其二,一一对应降低的是迁移成本,不是消除硬件差异。比如昇腾的缩放因子存储格式与英伟达不同,每一对UE8M0因子沿K维度打包进int16并按MN-major顺序存储。这类底层差异意味着跨平台仍需要持续的工程维护,而不是一劳永逸。
其三,也是最关键的,这套组件目前主要服务DeepSeek自己的模型形态,包括MoE、MLA、稀疏注意力。一个健康的硬件生态需要更多第三方模型、更多开发者、更多应用层工具跟进。生态的最终裁判是社区,不是发布会的官宣。
把视野拉高,这次开源的真正含义在于模型厂商正在成为跨硬件平台的关键变量。它既能在英伟达平台上把硬件性能榨干,也能把同一套软件栈平移到国产芯片上并再次逼近上限,并且把这条路公开给所有人。
算力多元化喊了很多年,多数时候停留在采购层面的第二供应商逻辑。而这次展示的是一种更实质的形态,模型层与芯片层的深度耦合,加上以模型厂商为主导的开放软件栈。当性能数据逼近硬件上限,当API在两个平台间一一对应,国产算力能否支撑前沿模型这个问题,正在被工程能力而不是口号所回答。
接下来的观察点很清楚,商用版HDK开放后的社区实测,更多模型团队是否跟进适配,TileLang的后端是否真的会出现在第三家芯片上。

 VIP复盘网
