

CPU正在重回舞台中央。
看完2026英特尔技术创新与产业生态大会,这是记者最直观的感受。2026年初,产业分析机构对2030年数据中心CPU总可寻址市场规模的预估是590亿美元;到了8月,同一机构将这一数字上修至2100亿美元。
是什么让他们改变了看法?智能体。
智能体改变了什么
要理解CPU为什么突然变得抢手,得先理解智能体和传统AI对话的本质区别。
英特尔数据中心集团副总裁、中国区总经理陈葆立在演讲中用三个软件工程概念来拆解这个差异。上下文工程赋予AI长时记忆,智能体AI能够记住与用户曾经的对话,使每一轮对话不再像“第一次见面”。工具调用相当于给AI“装上了手”——不仅能说,还能访问数据库、调用API、执行代码。而环路工程(Loop Engineering)最接近智能体的核心——模型像一名不断修改和调整答案的学生,题目发下来以后,它不只做一次,而是一次一次地再次验证、确认这个答案是对问题最好的回答。
英特尔数据中心与人工智能集团副总裁、中国区总经理陈葆立
中国工程院外籍院士、清华大学智能产业研究院(AIR)创始院长张亚勤在大会上给出了更精练的定义:智能体能围绕目标进行规划、行动、试错和迭代,直到完成任务。
举个例子:用户每天早上8点让AI搜集前一天的财经新闻并生成摘要。这个只有一句话的任务,运行链路远超想象:系统需要从网页、PDF、视频等异构源提取文本,分别做向量化处理,加载到模型分析,再根据分析结果决定是否调用更多数据源。每一次工具调用、每一次逻辑分支、每一次上下文索引,都伴随着新一轮CPU调度。
关键就在这里。传统大模型推理是单向流水线——GPU负责繁重的矩阵运算,CPU只做简单的数据搬运。但智能体的工作流本质上是反复的“计划—行动—评估—重来”循环,频繁的决策分叉、外部工具调用、记忆库检索。这些逻辑分支、状态管理和IO调度,恰恰是CPU架构的核心能力。
研究机构Semi Analysis的测算佐证了这一判断:在现代智能体代码工作负载中,约42%的执行时间被CPU驱动的工具调用所占用。佐治亚理工学院的研究结论更为激进——CPU侧的工具处理占智能体工作负载总延迟的90.6%。
智能体需要CPU
CPU与GPU的配置比例正在发生颠覆性变化。
在模型训练时代,一台AI服务器通常配8颗GPU、2颗CPU——算下来约等于4:1到8:1。GPU是绝对主角,CPU只是配套的“机头”。但进入智能体推理时代,这个比例正在发生结构性变化。
英特尔首席营销与传播官Annie Shea Weckesser在大会上明确表示,数据中心CPU与GPU的配置比例正从传统的4:1向接近1:1的方向演进。
英特尔首席营销与传播官Annie Shea Weckesser
华尔街已经从资本支出的角度捕捉到了这个信号。高盛的数据显示,在近期的AI基础设施资本支出中,CPU的份额已经超越了GPU。摩根士丹利的分析更为系统:Agentic AI可能在2030年前为数据中心CPU市场带来额外325亿至600亿美元的增量机会。
之所以产生这样的变化,是因为在智能体需求面前,CPU的确具有优势。
陈葆立给出了几组实测数据。采用Intel 18A制程制造、集成了288个核心的新一代至强6+处理器,单颗芯片上能稳定运行将近1000个智能体。在满足200毫秒SLA的严苛约束下,至强6+可实现350个沙箱并发,约为某一竞品实测值(240个)的1.46倍。在SWE-bench基准测试(业界公认的衡量智能体能力的开源基准)中,单智能体性能平均领先竞品15%。
智能体呼吁新型算力基础设施
英特尔将未来的数据中心划分为三类协同服务器集群。
第一层是CPU集群,负责智能体的执行与工作编排。这是智能体任务的核心调度层,用于拆解任务、选择工具、协调资源、管理状态。第二层是GPU智算集群,配备AI加速卡,承担模型推理与训练等算力密集型任务——也就是传统意义上的“Token工厂”。第三层是高性能存储集群,承载长对话记录、文档、合同、模型检查点等海量新增数据。
这三类集群有一个非常重要的共同点——都需要CPU来做数据调度。
在这个新架构中,KV Cache这一技术指标被重新重视。
大模型的上下文越来越长,智能体需要反复处理多轮对话信息。以35B参数的千问模型为例,百万Token上下文产生的KV Cache高达300GB,早已超过大多数GPU的HBM容量。这些数据必须卸载到系统内存甚至SSD中,而压缩、搬迁、索引这些缓存数据的任务,天然落在CPU肩上。
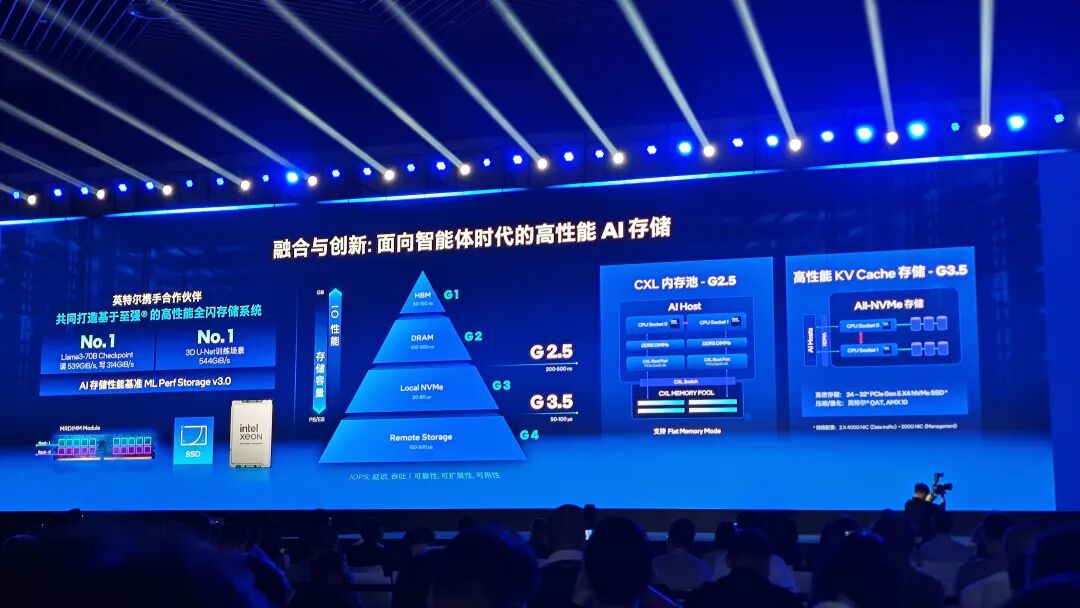
英特尔正在致力于建设面向智能体时代的高性能AI存储
陈葆立披露,至强6+内置的QAT(Quick Assist Technology)加速器可以对KV Cache进行无损压缩,300GB的数据可压缩至约200GB再落盘,能够节省约50%的存储成本。配套的IAA存储加速和AMX矩阵加速引擎,则可在数据预处理完成向量化和重排序,性能分别达到对比基准的2倍和4倍。
存储侧的生态实践也在跟进。大会期间,英特尔与忆联联合发布了面向智能体时代的高性能KV Cache G3.5方案,将企业级SSD从单纯的存储介质升级为KV Cache的大容量溢出层。而英特尔与焱融科技基于至强6和MRDIMM打造的存储系统,在MLPerf Storage v3.0基准测试的Llama3-70B检查点读写和3D U-Net训练两项中取得全球第一。
从芯片到整机柜、从压缩到存储——英特尔正在为智能体构建一套完整的算力基础设施。而CPU,是这套基础设施的“脊椎”。
“调度”变得重要
阿里云首席云服务器架构师陈健在大会论坛中,将AI算力发展划分为三个时代:2012年前的传统机器学习时代、2012年后的深度学习时代(GPU成为绝对算力中心)、以及2025年开始的Agentic AI时代。他的判断是:“智能体为解决任务而生,需要任务拆解、编排调度、工具调用——这些工作高度依赖CPU,CPU重新回到舞台中央。”
他紧接着强调了一个关键前提:“智能体时代不是CPU取代GPU,而是进入一个CPU与GPU深度协同的新纪元。”
这句话点明了问题的本质。CPU重新重要的真正含义,不是GPU不重要了,而是AI的瓶颈发生了转移。在训练时代,系统瓶颈是“算得快”——谁的GPU浮点性能更强,谁就占据优势。在智能体时代,系统瓶颈变成了“调度得顺”——任务拆解、工具协同、数据流转、状态管理的效率,决定了GPU能不能被充分利用,能不能在给定的时间窗口内交付一个完整的任务。
这也是为什么英特尔在大会上反复强调"开放"——开放Agent整机柜平台规范、开放x86生态、开源的Pytorch和Linux适配。在智能体时代,没有一个玩家能把从芯片到整机柜、从压缩算法到KV Cache分层、从云到端的全链路独自打通。拼单点性能的时代过去了,拼的是谁能用最标准化的基建,让最多的人在上面跑得最顺。
从更长的产业周期来看,CPU价值的重估,本质上是算力分工的一次重估。过去两年,全行业把AI等同于GPU,把算力等同于并行浮点运算——这是一个被训练时代塑造的惯性思维。但当AI从“聊天”走向“干活”,算力结构的重心,正在悄然从加速卡一侧,向CPU倾斜。

 VIP复盘网
