

具身智能领域最不缺的是“数据焦虑”,最缺的是“有效数据”。
当机器人模型参数从几百万跃升至几亿量级,高质量物理交互数据的供给能力,是否跟上了模型膨胀的速度?答案并不乐观。
根据此前披露的相关数据,当前国内真实物理交互场景合规数据仅50万小时,而机器人商业化落地需要数千万小时数据,缺口超过99%。
中国信通院发布的《具身智能训练场研究报告(2026年)》同样指出,具身基础模型要迎来“ChatGPT时刻”至少需要数千万小时数据,当前全球可用的高质量真实数据仅为数十万至百万小时级,远未达到支撑能力涌现的临界点。
这意味着什么?大语言模型拥有百亿小时级的训练数据积累,而具身智能的数据缺口,是3到5个数量级的差距。
但数据稀缺的真正原因,并不在于“没人采”。相关统计显示,过去两年,中国涌现出百座左右具身智能数据采集中心,从北京石景山到上海浦东,各类训练场密集落地。
真正的问题在于,大量采到的数据“不好用、用不上”——质量参差、格式割裂、跨本体不可复用。
数据稀缺的表象之下,藏着一个更深的病灶:数据基础设施的缺位。
01.
结构性短缺:拆解具身数据的三大矛盾
具身智能的数据困境,本质上是“结构性短缺”,至少由三层矛盾叠加而成。
第一层矛盾是采集成本高企。真机数据是具身智能最稀缺的资源,也是最昂贵的资源,尽管数据质量高、物理交互强、信息完整,但采集成本居高不下。行业测算显示,真机遥操作采集规模化运营后单小时有效数据成本约为275元,小规模采集阶段甚至可达数千元。
仿真合成数据虽能以较低代价生成海量样本、可覆盖长尾场景,却长期面临“Sim2Real Gap”的诟病。物理引擎很难百分之百还原真实世界的形变、摩擦与材质特性,虚拟世界里练出的技能,搬到真机上往往“水土不服”。
有学者将这种处境概括为具身智能数据的“不可能三角”——高质量、大规模、低成本,三者不可兼得。
更棘手的是,具身智能数据具有极强的硬件依赖性。不同机器人本体之间的数据格式、标注规范互不兼容,数据资产很难跨项目复用。同样一个抓取动作,一台身高1.2米的机器人与一台1.8米的机型,机械臂行程、传感器分布、力矩特性等完全不同,前者积累的经验很难直接迁移到后者身上。
数据的碎片化由此成为行业顽疾,形成了另一种形式的“数据孤岛”。
第二层矛盾是数采训练场的“产能扩张”与“质量焦虑”并行。如前所述,训练场作为数采新型基础设施正在加速落地,相关数据显示,全国已建成启用超过70家训练场,在建或规划中的训练场也有40多家,已形成规模化集群化布局。
然而,建设潮兴起的同时,质疑与争议同样袭来。相关报道将当前部分训练场的商业模式称为“循环融资”:机器人企业把机器卖给地方政府建的数采中心,再以采购数据的名义把钱流回去。
同时,集中式数采存在场景失真、成本结构不可持续、数据绑定本体且跨场景复用率低、实际产能有限等共性问题。
第三层矛盾是行业标准尚在建立,数据的“度量衡”缺失。不同团队采集口径、标注格式等各不相同,统一的可落地数据质量标尺仍在建立过程中。今年7月,工信部批准发布了具身智能领域首份行业标准《人工智能 关键基础技术 具身智能数据集质量要求及评估方法》(YD/T 6771—2026),将于11月1日正式实施。
标准的确立无疑是行业走向走向成熟的重要标志,但标准的落地执行还需要时间。目前,多数企业在数据采集、标注、使用环节中仍然各自为战,缺乏统一的工具链和评测框架。
三层矛盾共同指向一个问题:“更多的数据”不等于“更有效的数据”。对于行业而言,真正稀缺的,是将非标数据世界炼成标准化“燃料”的能力——这正是数据基础设施存在的理由。
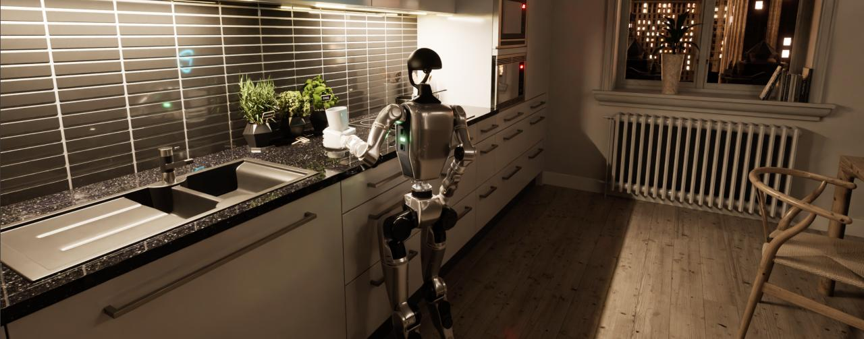
具身智能虚拟训练测试场
02.
无问智科的解法:Real2Sim2Real,在虚实之间架一座双向桥
在行业普遍焦虑之时,无问智科选择了一条更具系统性的路径:打造全链路打通的“采、标、训、仿、验”数据基座,以Real2Sim2Real闭环,构建虚实融合闭环的数据范式。
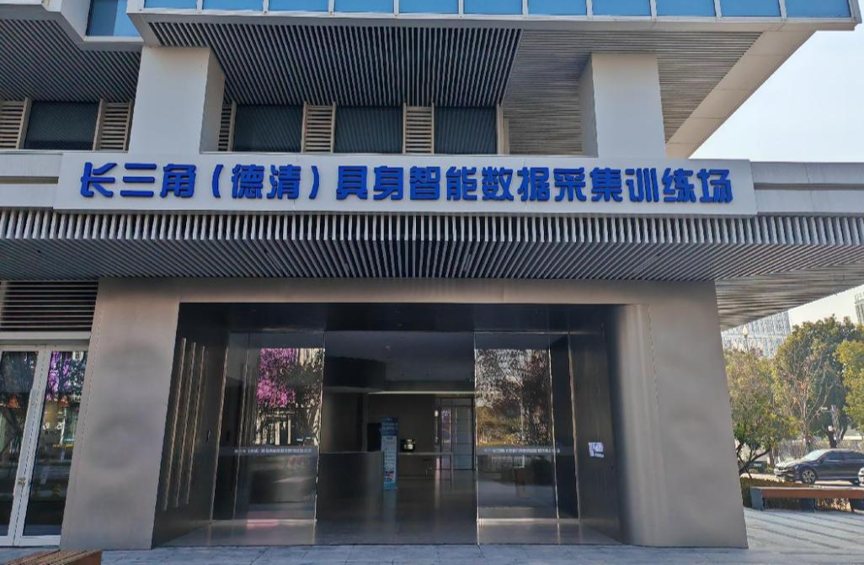
在采集层面,无问智科牵头打造了长三角规模最大的具身智能数据采集训练场。该长三角(德清)具身智能数据采集训练场,拥有室内3000平方米、室外封闭场地505亩、全域开放场景937平方公里的三级训练体系,覆盖物流仓储、家庭服务、酒店文旅、工业制造、办公服务、商业零售六大核心场景。
截至目前,训练场已实现年数据产能超千万条,多模态有效数据超900TB,含120万条原子动作轨迹,覆盖500+真实场景、230余种复杂任务,场景还原度99.5%,能够持续为具身智能模型训练提供真实数据养料。
采集只是数据价值的起点,从原始数据到模型可用的“Model-Ready”状态,中间隔着标注这条深沟。无问智科自研的wwDataEngine数据平台,基于10B级多模态自动标注Agent,采用MOE混合专家模型架构,可实现90%以上的召回率与准确率、70%以上的效率提升,以及99%以上的交付准确率。
该平台的多传感器时空标定精度可达像素级,可根据自然语言进行自动规则配置,并通过自动增量式微调框架持续迭代模型能力,让数据标注从“劳动密集型”走向“智能驱动型”。同时,平台采用MOE模型解决域适应能力问题,通过不同专家解决不同场景的推理理解,将单任务升级为多任务,2D与3D信息互补,支撑多模态标注任务。
独创的Real2Sim2Real双向闭环体系,是无问智科最具差异化的技术底座。“scan2sim孪生级重建+gen2sim生成式泛化”双管线架构,能够实现从一个真实场景衍生出成百上千个“表亲变体”——保留核心几何结构和语义功能,同时在外观、纹理、物理属性层面实现泛化,让具身大脑模型学习任务本质,而非记忆特定场景。
世界理解模型构建的自动化数据生产管线
目前,无问智科已将SimReady资产的构建时间从3天缩短至5分钟,并建立了百万级SimReady资产库。
除此之外,wwSim物理AI仿真平台的搭建同样关键。通过联合渲染引擎与物理仿真引擎,无问智科实现了“场景生成-数据生成-模型训练-仿真评估”的闭环。真实数据为模型提供现实世界的“锚点”,仿真数据则扩大场景、任务及长尾样本的覆盖范围。
高精度世界生成物理仿真
据悉,在开源真机数据集基础上加入无感野采数据后,模型在篮子收纳任务中的成功率提升约20%;在与头部客户开展的虚实融合闭环验证中,在线强化学习使模型仿真成功率由9.7%提升至79.8%,迁移至真实机器人后,任务成功率提高超过50%。
大规模无感野采范式高效获取数据
一个完整的“数据驱动飞轮”已然成型:真实数据降低仿真Gap,仿真数据反哺模型泛化,模型落地场景再产生新的高质量数据。无问智科用Real2Sim2Real的闭环,在物理世界与数字世界之间架起了一座双向通行的宏桥。它让仿真告别了“理想化”的空中楼阁,也让真实数据突破了“昂贵且低效”的物理桎梏。
03.
资本正在为“数据基建”投票
资本向来是最敏锐的风向标。
2026年9月,无问智科宣布完成数亿元A轮融资,由洪泰基金领投,洪山资本、中电数融、狮城资本跟投,架桥资本、力合金融、力合中科、澄凯灵澄未来基金等老股东超额追投。
在资本愈发谨慎的大环境下,融资不仅是资金注入,更是资本市场对其“数据基座”战略方向与技术团队的深度认可。
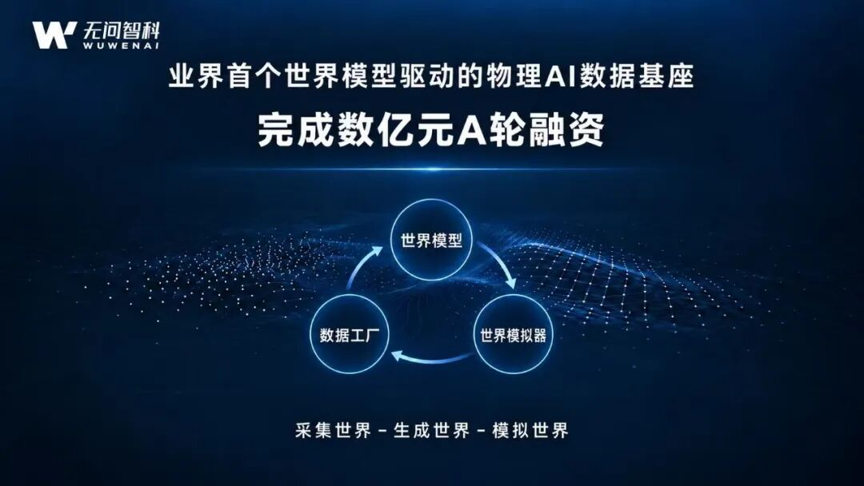
无问智科完成数亿元A轮融资
比融资更值得关注的,是商业化落地的加速度。据公司披露,无问智科具身智能业务订单已达数亿元,订单同比增长超过3000%,预计收入同比增长超过1000%,头部客户覆盖度和客户复购率均超过80%。
长期合作客户涵盖星动纪元、它石智航、灵心巧手、零次方等具身智能企业,2026年Q1与字节跳动、无界动力、章鱼动力等签订订单,已形成“技术研发—场景落地—价值变现”的完整商业闭环。
与此同时,无问智科牵头打造的德清训练场已构建起豪华合作生态阵营,星动纪元、灵心巧手、云深处科技、地平线、浙江大学等十余家国内前沿企业和高校深度参与其中。
在合作模式上,无问智科定位为“数据驱动飞轮”的核心枢纽:向下连接场景方获取真实场景与原始数据,向上为机器人本体公司提供采集、标注、训练、仿真、验证一体化解决方案,帮助其快速迭代算法,达到场景方的使用需求,形成数据驱动的价值闭环。
04.
基础设施是慢变量,但它决定所有快变量的极限
基础设施从来都是“慢变量”,却决定所有“快变量”的极限。物理AI的规模化,同样需要数据基座这样一座“看不见的地基”。
在千行百业等待具身智能赋能的今天,无问智科选择做那个“修地基”的人。其以世界模型×数据工厂×世界模拟器为核心,用Real2Sim2Real闭环将物理世界的复杂性“编码”为可训练、可评测、可复用的数据资产。
从长三角(德清)训练场的千万级数据产能,到wwDataEngine的10B级自动标注能力,从scan2sim孪生级重建到gen2sim生成式泛化,无问智科构建的不仅是一套技术工具链,更是一套面向物理AI时代的工业化数据生产范式。
当行业从“有多少数据”的焦虑,转向“数据有多大用”的冷静,那些真正懂得如何把非标世界炼成标准燃料的基础设施玩家,将拥有定义赛道规则的权力。而无问智科,正站在这场范式转移的最前沿。

 VIP复盘网
