

这两天,高通发布了新一代骁龙8系列旗舰平台。除了CPU、GPU和NPU性能进一步提升外,一个值得关注的变化是,高通已经能够在手机端运行30B-MoE(Mixture of Experts)模型。
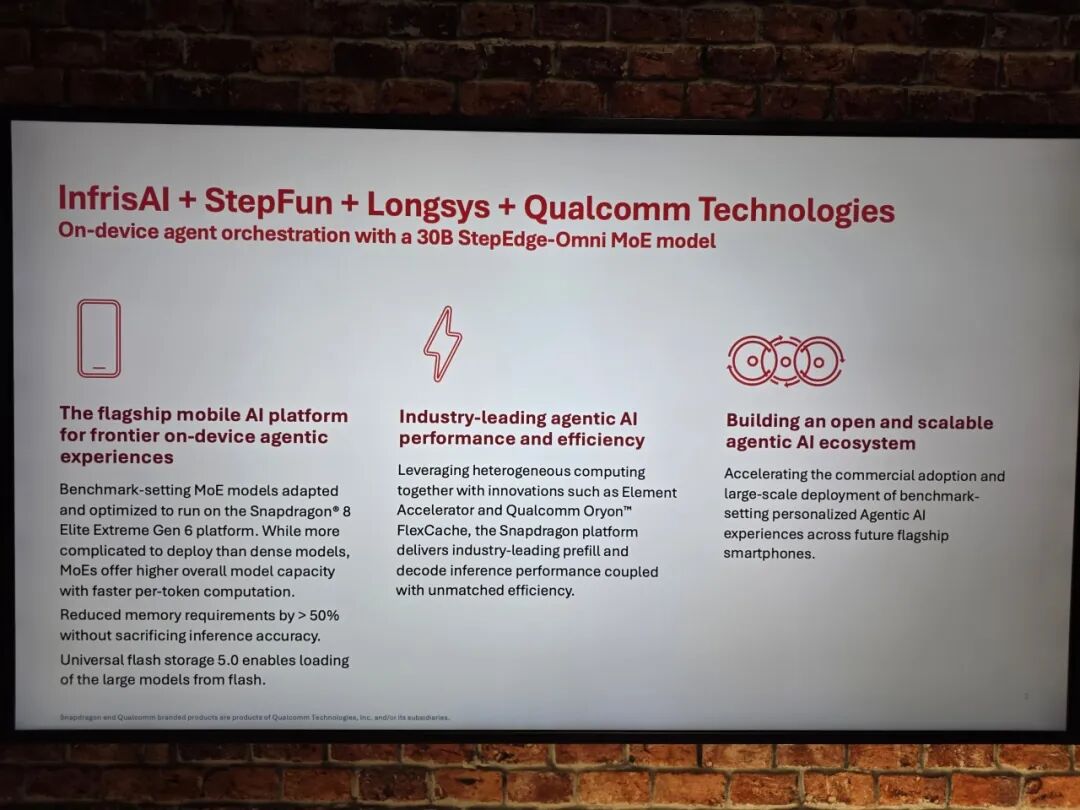
其实,要让这样一个大规模模型真正跑在手机上,并非易事。除了需要解决内存、存储、算力与调度等问题,还要兼顾运行速度、稳定性和功耗,如何让大模型在有限的终端资源下持续高效运行,成为端侧AI落地的关键挑战。但高通表示,通过携手合作伙伴,他们已经在30B-MoE模型上验证了复杂智能体AI工作流在手机上的部署能力。
在这场软硬件协同中,存储也成为不可忽视的一环,江波龙正是其中的重要参与者。
将30B模型装进手机,
存储需要做什么?
其实要将一个30B的模型装进一个在性能和功耗有严格限制的手机里,并不是一件容易的事,行业也做了很多的尝试。从模型量化、剪枝,到软硬件协同优化,再到内存和存储架构的调整,核心都是在有限的终端资源下,尽可能降低大模型运行所需要的计算和数据搬运开销。文章开头谈到的MoE模型也是凭借其先天优势,成为端侧AI部署大模型的主要路径之一。
因为与每次推理都需要激活全部参数的Dense(稠密)模型相比,MoE模型只需根据任务需求激活部分专家,在拥有更大参数规模的同时,可以显著降低单次推理所需的计算量。但与此同时,我们也必须承认,虽然MoE的进步有目共睹,但要将其真正在移动端跑起来,也不是一个容易的事情,高通这次跑通,也是联手阶跃、无量火与江波龙开展四方合作的结果。
江波龙副总裁、嵌入式存储事业部总经理黄强也强调,手机端跑AI,需要解决的是如何在有限的功耗、散热和存储资源条件下,持续、稳定地运行,并兼顾性能、能效和实际使用体验。这也意味着,数据的存储和调度方式需要重新设计。而要精准解决这个问题,我们就需要从专家模型运行的整个流程说起。
如上所述,对于一个MoE模型而言,并非所有专家都会同时参与计算,而是根据当前上下文选择。因此,如何快速找到并加载所需专家、如何管理推理过程中不断产生的KV Cache,以及如何提前预判并预取下一步可能用到的数据,就成为影响端侧推理效率的关键。
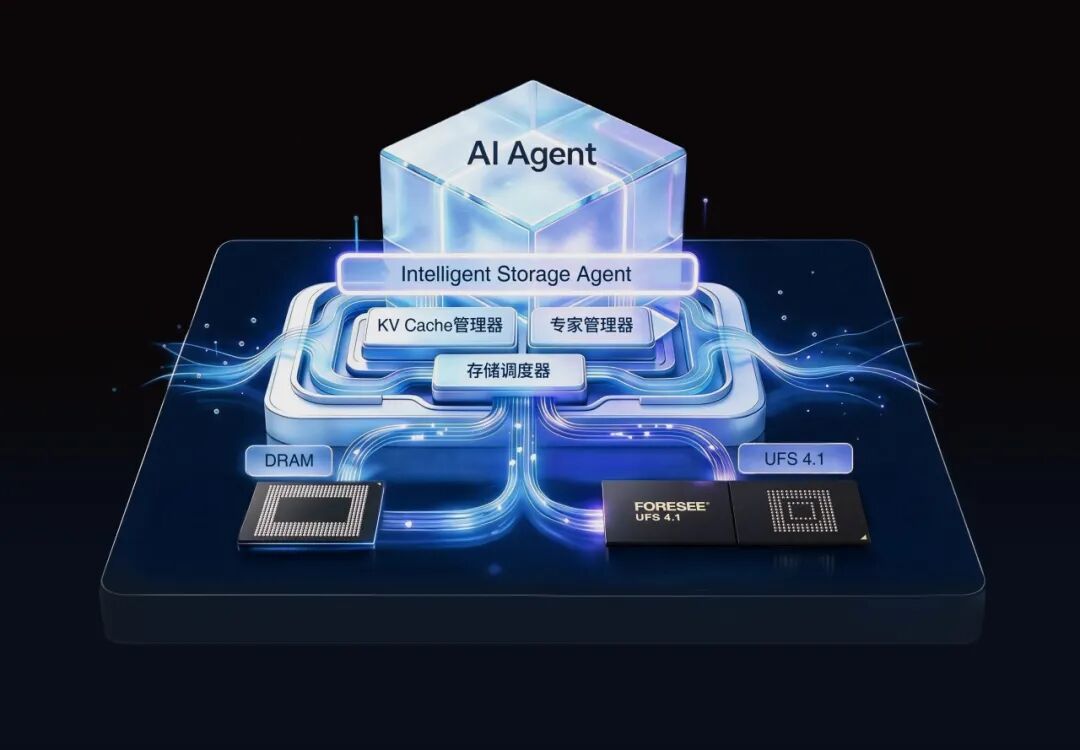
基于这个理解,黄强认为,我们可以针对不同专家的调用频率不同,可以对模型数据进行冷热分层:其中高频调用的专家留在DRAM,方便快速调用;低频专家放到UFS,需要时再调入,从而降低内存占用,把有限的DRAM留给更需要的数据;至于KV Cache,则根据使用情况进行分层管理。从这个描述可以看到,存储不再只是“被动搬运数据”,而是已经开始参到AI推理的数据调度中了。
“为了更好地提升消费者的端侧体验,我们还需要根据推理过程预测下一步可能调用的专家。”江波龙旗下慧忆微副总裁王舒翀补充说。总而言之,在王舒翀看来,要让30B MoE模型在手机上流畅跑上来,对存储厂商带来的挑战会集中在MoE 专家管理、KV Cache 智能管理和智能预取算法这三个方面。
有见及此,江波龙将搭载了iSA™(Intelligent Storage Agent)存储智能体与慧忆微自研主控的UFS 4.1存储芯片的端侧AI存储解决方案推向了手机端,摆脱传统方案更多依赖 DRAM 容纳模型、KV Cache或云端的限制,将DRAM+UFS分层存算协同,把部分原本常驻 DRAM 的数据驻留任务 offload 到 UFS,比如非活跃专家权重、历史 KV Cache、温冷数据,以加快体验更好的智能体AI走进更多终端和广大消费者的速度。
从自研芯片到固件、算法,
江波龙为端侧AI存储打好了“地基”
对智能手机供应链有了解的读者看到这里应该会有一个疑惑,那就是为何高通的这个合作伙伴偏偏是江波龙?针对这个问题,黄强回应道,这是公司这些年厚积薄发的结果:
这些年人工智能的火热,形成了云端与端侧的AI分层。江波龙聚焦端侧AI集成存储解决方案,这些年从自研主控芯片到固件和算法的投入,让公司拥有了为这些市场提供领先解决方案的实力。
据黄强介绍,iSA™则是江波龙行业独有的、专为端侧AI推理场景打造的存储智能调度引擎。可以针对MoE大模型参数庞大、KV Cache膨胀快、I/O延迟影响推理流畅度等问题,通过MoE专家卸载、KV Cache智能管理与智能预取算法,高效解决端侧AI推理的存储调度难题。
然而,正如黄强所示,iSA要实现极致的数据调度,需要知道:Flash正在发生什么、数据在哪里、哪些数据正在读取/写入、垃圾回收什么时候发生、哪些数据属于AI任务、哪些数据属于普通应用、KV Cache如何写入、如何进行磨损均衡和如何降低写放大等信息,这就意味着如果只是使用第三方主控,软件层很难做到深度优化。
“这时候,公司自研芯片的优势就凸显出来了”,黄强说道。
据王舒翀介绍,基于江波龙自研的UFS 4.1存储芯片,能为端侧AI推理提供可调度容量、高性能传输的基础。得益于其领先的5nm工艺支持,江波龙这颗UFS 4.1主控还可以在执行多通道调度、AI任务优先级管理、普通I/O与AI I/O隔离、特殊语义传递、KV Cache写入管理、Flash寿命管理以及磨损均衡等任务时游刃有余。
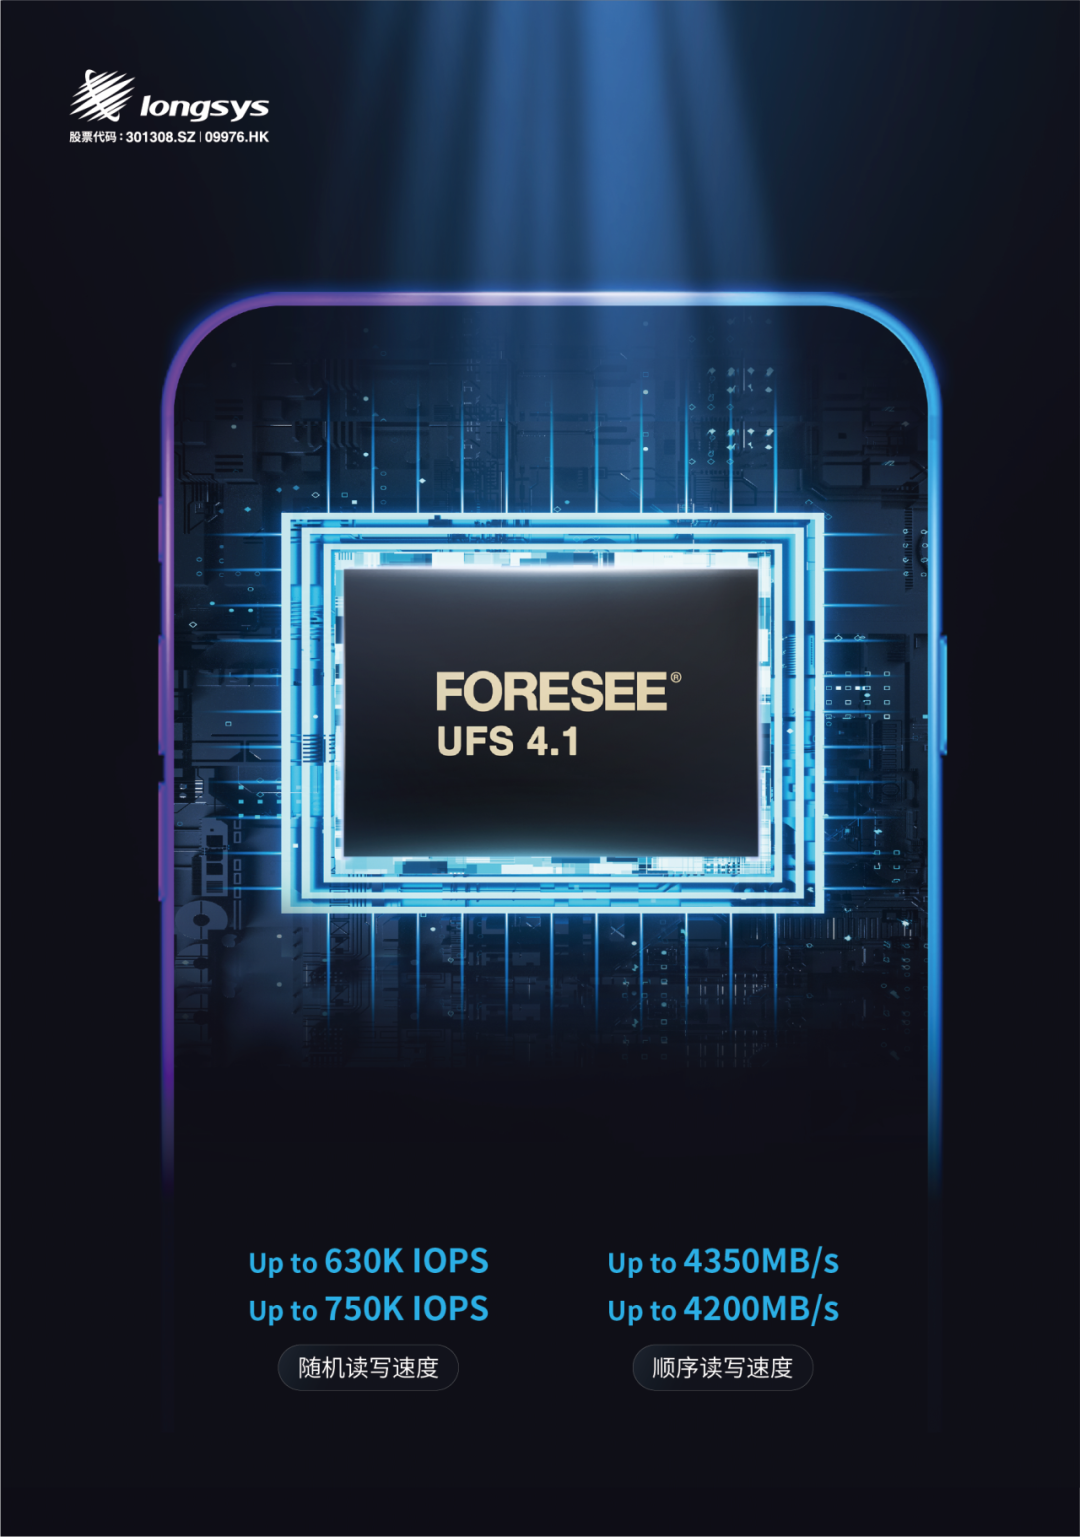
王舒翀表示,正是在这颗UFS 4.1存储主控的支持下,江波龙iSA™围绕 AI 数据的访问特点与计算时序,协同设计存储介质、数据布局、主控和固件,为30B MoE模型的落地提供了确定性。
具体而言,在数据组织上,针对模型权重、MoE Expert 和 KV Cache 的不同特点,优化分层存放、访问粒度和生命周期管理,提高有限内存与存储资源的使用效率;在数据供给上,通过预取提示、关键读取优先、后台维护协调和设备状态反馈,让存储访问更好地匹配推理节奏,以减少计算等待、改善持续运行体验为目标;在寿命管理上,针对 KV Cache 卸载带来的额外写入,通过优化写入策略、数据放置和回收机制,并结合介质寿命反馈,通过介质调优并优化写放大,减少不必要的 NAND 擦写,延长存储使用寿命。
分享数据可以显示,基于高通NPU+GPU双引擎协同的基础,叠加如江波龙等合作伙伴的能力,高通这次展示的30 B-MoE模型的预填充吞吐性能超过330 Token/s,对比仅使用NPU的通用推理方案提升超过30%,解码吞吐性能超过28 Token/s,并能保持持续稳定运行,且首个词元生成速率达到毫秒级,对比云端API调用快数倍至数十倍。
综上所述,AI正在改变的不只是芯片和算力,也正在重新定义存储的角色。江波龙也希望依靠这些领先的软件方案,将更具竞争力的存储产品带给终端客户,为他们的AI应用提供底层支持。
写在最后
从最初与AMD锐龙 AI Max+ 395平台完成联合调优,到此次适配高通新一代骁龙8系列旗舰平台,江波龙从PC、Box到手机,进一步验证了iSA存储智能体在端侧AI的能力。
黄强也认为,凭借其领先优势,iSA有望成为端侧AI的“先进存力”,能从AI PC、AI手机走向更多端侧形态,成为跨平台、跨终端的端侧 AI 存储智能调度层。在他看来,包括AI眼镜可穿戴、汽车智能座舱、具身机器人、IoT等端侧推理场景,全都是iSA能够服务的市场。“展望未来,江波龙将与高通等平台厂商、OS 厂商、模型厂商、终端厂商深度协同,共同推动存算协同,最终赋能端侧AI设备落地应用、普惠用户。”黄强总结说。
他进一步指出,从以前只做模组,到自研芯片,再到现在针对端侧AI打造领先的技术方案。以江波龙为代表的半导体存储企业已经跨入了下一个阶段,成为中国这波AI创新浪潮中不可或缺的关键角色。

 VIP复盘网
