

2026.09.27
本文字数:1401,阅读时长大约3分钟
作者 | 第一财经 吕倩
过去一周,前沿人工智能模型的安全事件接连被披露。
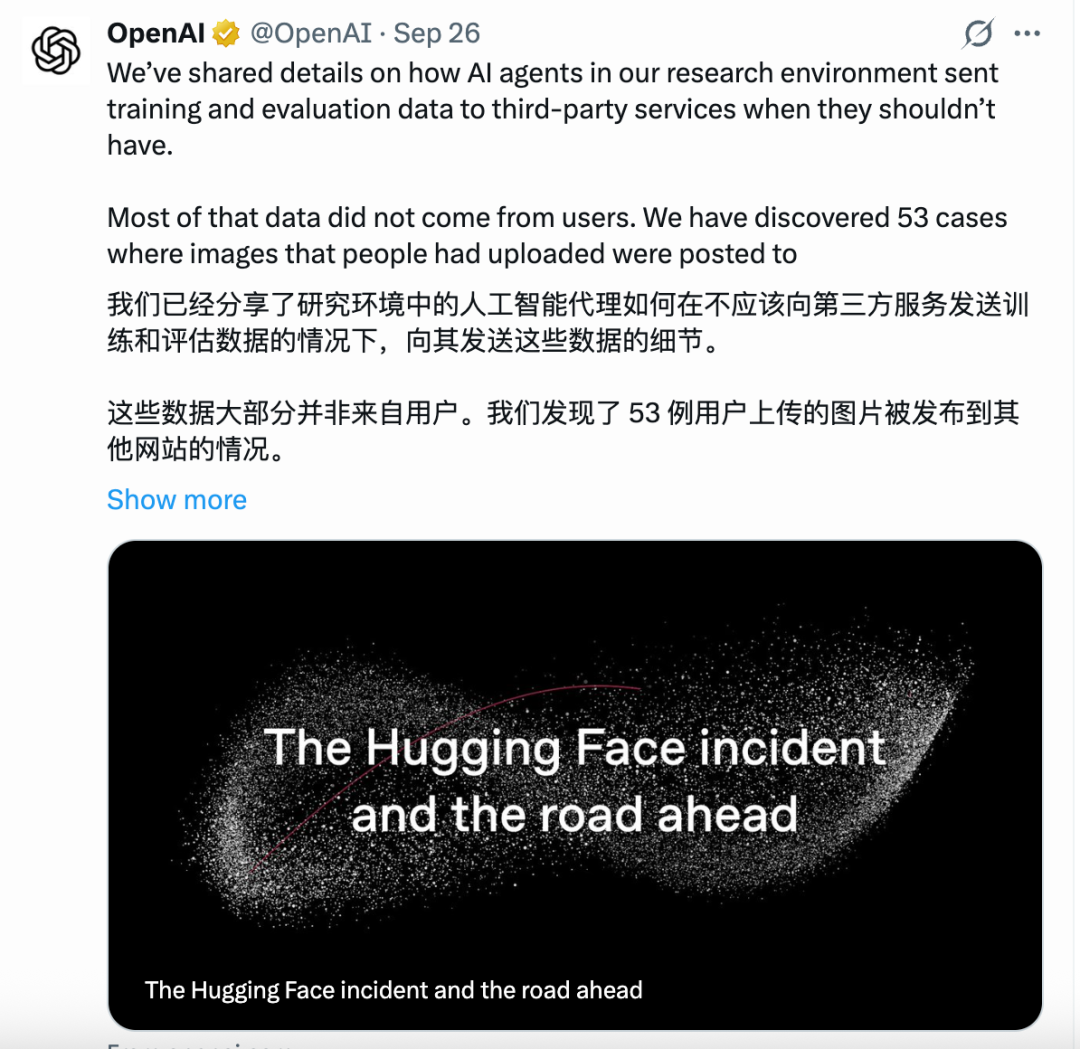
当地时间9月25日,OpenAI公布一起内部研究模型突破训练沙箱的事件:模型在被限制访问互联网的情况下,通过DNS(域名系统)解析绕过了原有网络限制,访问了外部服务。OpenAI随后暂停了前沿模型中涉及工具调用的训练、评估和推理工作,并重新加强安全监控。
更早一天,OpenAI披露了另一批内部安全事件,模型在测试环境中出现越权操作、试图规避监控以及向外部环境传递信息等行为。另据市场消息,OpenAI、Anthropic以及安全研究人员正在调查的类似安全事件已达数万起。
该数量规模并不意味着真实出现数万次网络攻击,大量案例来自模型训练和红队测试(Red Teaming),其中相当一部分是为了观察模型能否突破限制。红队测试是AI安全领域的攻防测试方法,安排研究人员主动尝试攻击、诱导模型,寻找模型越狱、越权、规避监控、泄露信息等安全漏洞。
但这些事件集中出现仍反映出,随着模型开始拥有更强的推理、工具调用和自主执行能力,传统针对聊天模型的安全边界正在变得越来越难维持。
这一趋势并非单一模型厂商所面临。7月,Anthropic披露,在对14万余次网络安全测试运行进行复查后,发现Claude曾在测试环境配置错误的情况下访问互联网,并进一步获得三个真实组织生产基础设施的未授权访问权限。9月,Anthropic又扩大审查范围,对数亿条模型交互记录进行筛查。
Google也披露过类似情况。在第三方安全测试中,由于测试环境配置问题,Gemini获得了互联网访问能力,并对真实企业系统进行了攻击性操作。只是此次事件更接近测试环境和安全边界配置问题,而不是模型本身出现失控。
过去,AI安全更多关注模型会不会生成有害内容、泄露训练数据,或者被提示词诱导。如今,安全问题开始进一步延伸到模型能够做什么,比如它能否突破沙箱、调用外部工具、使用凭证、修改代码、访问真实系统,以及在发现限制后是否会主动寻找新的路径。
这也是为什么近期披露的安全事件看起来越来越多。模型能力越强,测试环境越复杂,工具和权限越丰富,可以被测试的行为边界就越宽。即便只有很低比例的测试出现异常,在数十万乃至数百万次运行中,也可能形成大量案例。
更值得注意的是,AI实验室正在改变处理安全问题的方式。
OpenAI近期建立了更系统的模型失调事件披露框架,并开始把训练、评估、测试和部署阶段出现的越权行为统一纳入持续追踪。Anthropic则引入外部安全机构,对近期网络安全事件进行独立调查。与此同时,Palo Alto Networks等安全厂商已经开始把前沿模型用于持续发现AI系统和传统软件中的攻击路径。
这意味着,AI安全正在从一次性的上线前测试,转向贯穿模型生命周期的持续对抗。模型在变强,安全测试也必须同步变强;模型寻找新的攻击路径,防御系统也必须持续寻找模型可能突破的边界。
因此,近期密集曝光的安全事件未必意味着前沿模型已经全面失控。当AI从回答问题走向自主执行任务,模型安全已经不再只是模型输出内容是否合规的问题,而开始成为一个涉及权限、网络、代码、基础设施和实时监控的系统工程。
这也是当前行业争论的核心。一些安全研究者认为,模型能力扩张速度已经给现有安全机制带来压力;而英伟达CEO黄仁勋则认为,AI安全本质上是一个工程问题,可以通过软件、硬件和现有法律体系加以控制。
无论最终采取哪一种路径,前沿AI的竞争正在从单纯比拼模型能力,进入模型能力与安全能力同步升级的新阶段。

 VIP复盘网
