依托ISC IO500前十底座,优刻得UPFS实现跨节点KV Cache持久化卸载,赋能Agent推理存储
时间:2026-09-24 10:08
上述文章报告出品方/作者:优刻得云计算;仅供参考,投资者应独立决策并承担投资风险。
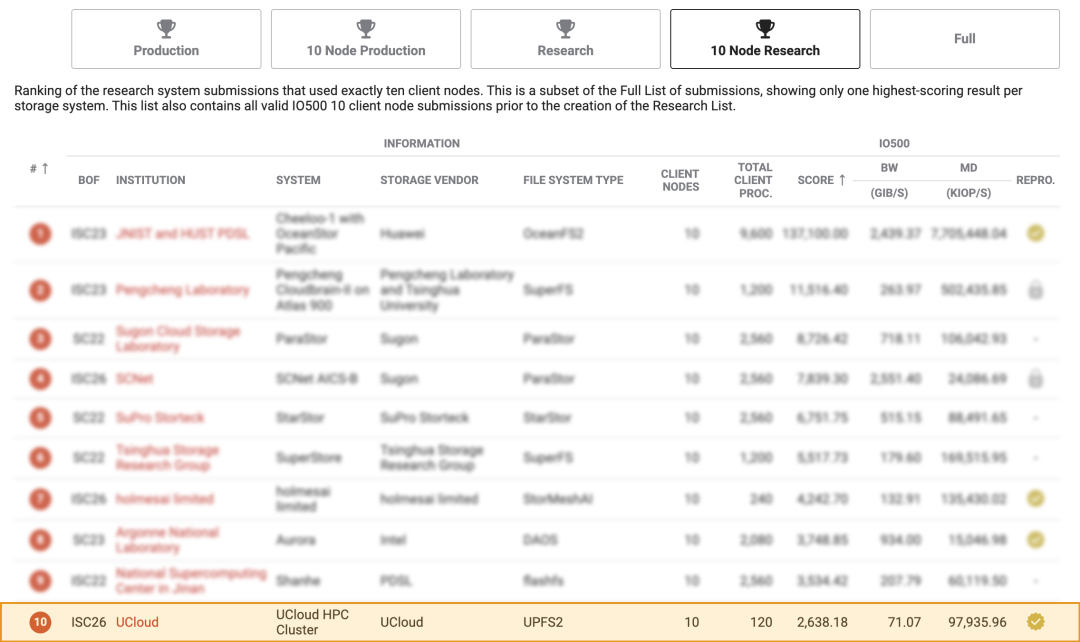
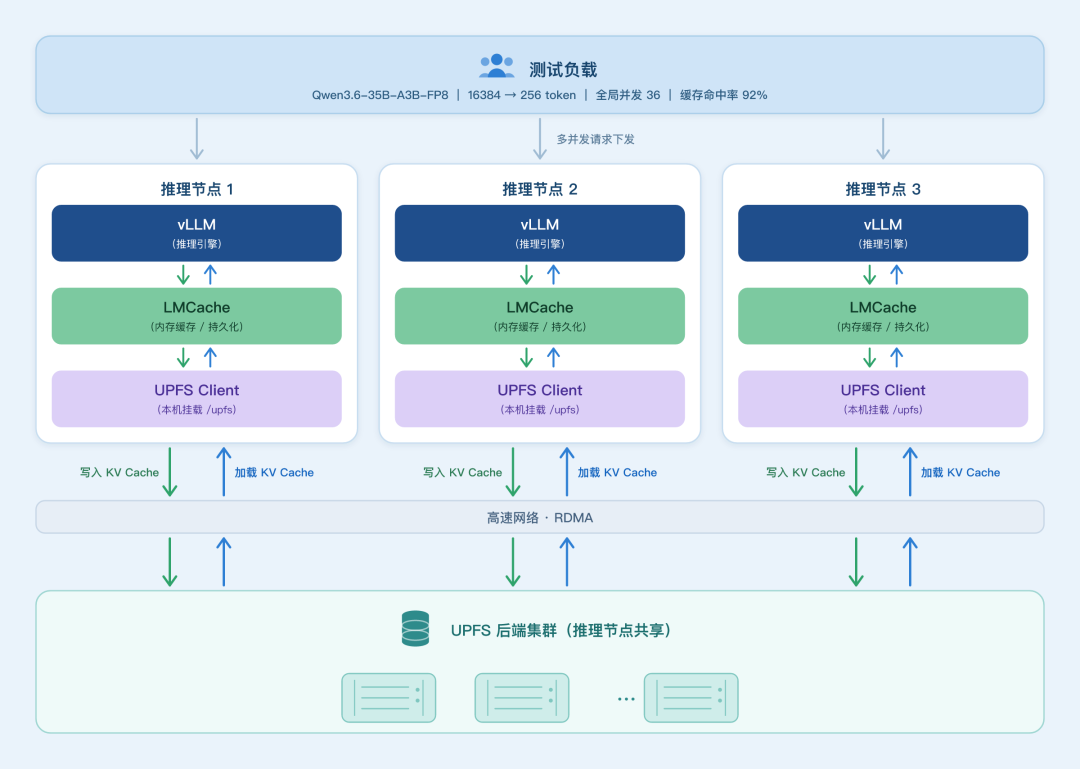
Agent业务与超长上下文推理的快速普及,让KV Cache显存墙的矛盾进一步凸显。即便搭载141GB超大HBM3e显存的H200算力卡,面对多并发长文档会话,GPU本地显存依然不足以容纳全部会话KV张量。行业已经形成清晰共识,推理走向“热-温-冷”三级分层存储架构——最热KV保存在GPU‑HBM;中频KV下沉至CPU‑DDR;大量低频可复用的冷KV Cache卸载到远端分布式共享存储池。作为优刻得自研的高性能并行文件系统,UPFS已于2026上半年ISC IO500榜单跻身全球前十,在带宽、元数据并发两项核心指标上获得国际权威基准认可,具备AI智算场景高并发元数据访问与大带宽吞吐的底层能力。基于这套经过IO500榜单验证的POSIX全闪并行底座,依托开源LMCache的标准后端抽象层,UPFS完成多GPU节点跨机KV缓存共享集群实验室验证。自此,不需要采购全新专属KV硬件集群,基于存量AI存储集群就可以落地远端KV Cache卸载方案,为智算推理集群提供分层存储路径。方案架构:基于LMCache生态的KV Cache卸载实现UPFS对vLLM推理引擎做到零侵入适配。vLLM将KV缓存卸载能力抽象为标准后端接口;LMCache作为中间适配层,既可以对接Mooncake-Store、Redis等原生KV后端,也可以通过文件语义,将KV张量持久化写入UPFS并行存储集群。在标准LMCache文件后端能力基础上,UPFS进一步围绕长期运行下的L2容量治理和远端存储异常隔离进行了工程化增强,使远端KV Cache不只是能够落盘共享,也能够适应生产环境下持续写入、容量增长以及存储延迟波动等场景。- 分层职责清晰:LMCache负责KV Cache生命周期管理及L1 LRU淘汰;UPFS提供共享L2 KV的持久化、空间管理及高速读写能力。针对文件后端长期运行过程中KV持续累积的问题,UPFS侧补充容量水位管理和后台回收机制,对历史冷KV进行持续清理,避免L2缓存无限增长;
- 远端缓存异常不阻塞推理主链路:针对共享存储可能出现的瞬时延迟升高或短时不可用,我们在L2访问链路增加超时、快速失败和熔断旁路机制。当UPFS无法在预期时间内返回数据时,该次访问可直接按Cache Miss处理,由推理引擎重新计算KV,而不是持续等待远端存储恢复,从而把存储异常的影响限制在缓存命中率和推理性能范围内;
- 支持跨进程、跨GPU计算节点缓存共享:不同vLLM推理实例之间可以读取复用远端存储上已经生成的KV张量;依托UPFS高并发元数据能力,支撑大量小KV文件的并发访问;
- 缓存持久化与计算实例解耦:vLLM滚动重启、实例迁移后,已经持久化到远端的KV Cache不随GPU计算实例释放,可继续被后续请求复用,降低计算节点重启或会话漂移带来的缓存重建成本。
生产环境Agent会话会被调度到不同GPU节点;如果缓存只能本地保留,会话漂移就直接发生缓存miss,需要全部重新prefill。本多机测试模拟会话跨节点漂移的真实业务调度场景。- 集群拓扑:3台GPU计算节点 + UPFS全闪并行存储集群;Spine‑Leaf组网,400G RoCEv2
- 算力资源:3台GPU服务器,每台2×H200‑SXM(合计6张H200‑SXM,141GB HBM3e);vLLM共启动3组独立推理服务实例,全部指向同一套远端UPFS共享存储池
- 软件栈:vLLM‑0.26.0 + LMCache;模型Qwen3.6-35B-A3B-FP8;TP‑2,每台服务器运行一套TP‑2推理副本
- 测试负载:输入16384 token长上下文、输出256 token;全局并发36;采用共享长前缀人造重复请求;受控环境全局缓存命中率维持92%
- 基线对照组:GPU‑only基线,全部KV Cache保存在GPU显存本地完成prefill计算
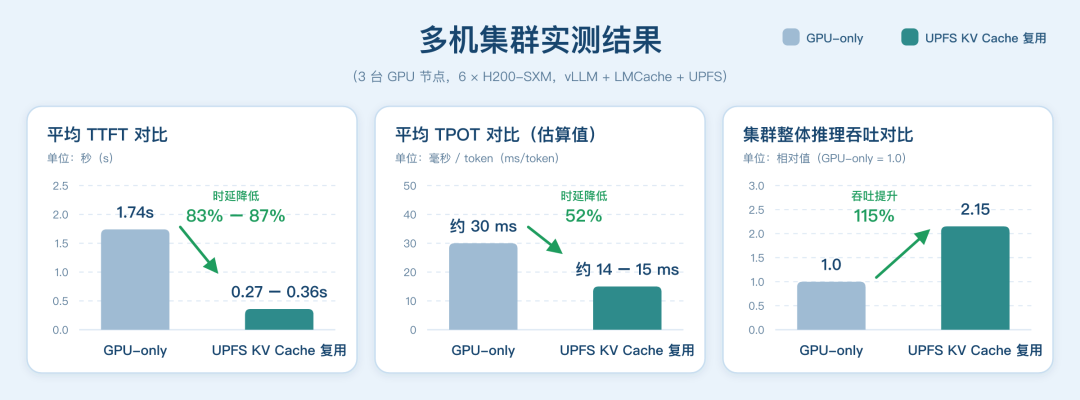
相比基线GPU-only,远端KV共享显著改善了长上下文推理性能:平均TTFT从1.74s降至270–360ms,降幅达到83%–87%;生成阶段TPOT从约30ms/token降至14–15ms/token,降低约52%;集群整体推理吞吐提升约2.15 倍。与此同时,多机高并发场景下p99 TTFT仍受到文件系统元数据长尾影响,这也是后续重点优化方向。✅底层经过IO500权威验证。UPFS在2026上半年ISC IO500榜单跻身全球前十,元数据与大带宽能力经过国际基准严苛检验;而KV Cache远端卸载恰恰对存储系统的元数据并发能力、低延迟读写能力提出很高诉求;IO500的成绩为本方案打下坚实底层性能基础。✅存量AI存储集群利旧,控制推理基建CAPEX。已经部署上线UPFS全闪AI并行存储集群的客户,即可直接承接冷KV Cache下沉负载,不需要额外采购专门KV Cache专属一体机;同时通过L2容量治理和存储异常旁路机制,让远端缓存能够长期运行,又不成为推理服务的强依赖,存量硬件即可快速落地分层缓存架构。✅完全对齐开源推理生态,业务侵入性极低。基于LMCache标准后端抽象层对接新版vLLM,不需要修改推理引擎内核;原生兼容Qwen3.6、GLM‑5、DeepSeek‑V4等2026主流开源大模型;业务上层代码改动量很小。✅支持跨GPU节点会话缓存共享,适配Agent会话漂移运维场景。多推理实例跨机器共享一套远端KV缓存池;当会话被负载均衡调度漂移到别的GPU节点,依然可以复用历史prefill结果,显著提升全局集群整体缓存命中率;同时支持vLLM滚动升级之后缓存持久保留。- 中等规模Agent推理集群、长文档知识库问答、多轮会话业务;
- 用户存量已经部署UPFS并行AI存储,希望优先利旧存量存储资源落地KV Cache分层卸载;
- 业务存在一定比例重复文档、重复系统prompt,会话前缀具备可复用基础的推理业务。
大模型推理分层存储,是Agent时代AI基础设施的明确演进方向。UPFS作为经IO500权威认证的国产自研并行文件系统,正持续深耕AI从训练到推理的全链路存储能力。它在充分释放存量AI存储集群价值的同时,不断打磨KV Cache远端卸载能力,为大规模Agent推理场景提供了一套务实可行的落地方案。



 VIP复盘网
