9 月 19 日,arXiv 上出现一篇署名包含梁文锋(Wenfeng Liang)的论文。
这不是一篇模型论文。它的学科分类是 cs.DC(分布式、并行与集群计算),不是 cs.LG 或 cs.AI。31 页、13 张图、131 位作者。前身是投给 ACM SIGOPS ATC 2026 操作系统方向(OSC Track) 的两页 extended abstract,已通过首轮评审,本次是大幅扩写后的完整版。
论文基本信息
- 标题:DeepSeek Elastic Compute (DSec): A Sandbox Infrastructure for Effective Agentic Training at Scale
- 作者:Jialiang Huang、Hongxuan Tang、Jingchang Chen 等,共 131 位
- 地址:https://arxiv.org/abs/2609.22978
论文讲的是 DeepSeek 内部支撑 Agent 训练的那层「地基」——DSec(DeepSeek Elastic Compute),一个生产级沙箱平台。
论文明确写了:从 DeepSeek-V3.2 到 V4.1 的全部 Agentic RL 训练、评测与环境构建负载,都跑在它上面。
这篇论文把长期被当成「黑盒」的 Agent 执行环境,做成了一套与强化学习框架协同设计的生产级平台。
- 规模:一个规模单元约 160 台 CPU 节点、3 万核、250 TB 内存,单日服务约 300 万沙箱,峰值并发 38 万+,创建速率 5000+/秒;
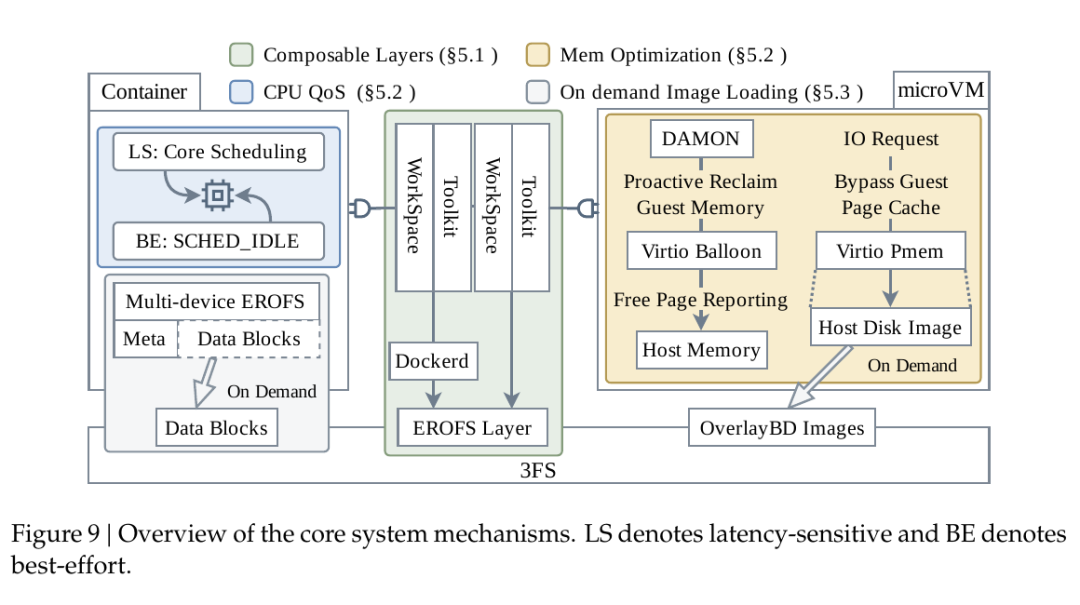
- 环境组合:把基础镜像、工作区、工具包拆成独立版本化的只读层,运行时拼装,维护成本从 O(m·N) 降到 O(m)——改 dockerd 只用了 30 行 Go;
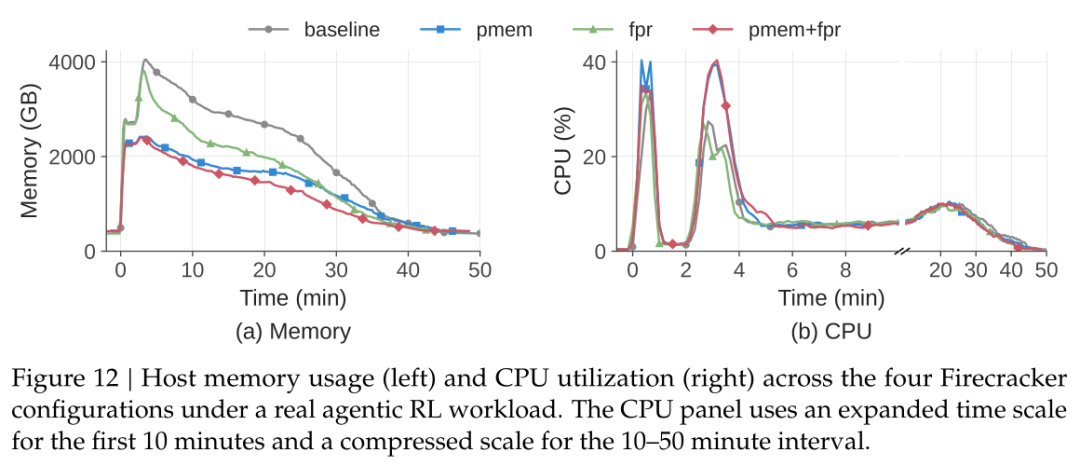
- 极限超卖:90% 的沙箱平均 CPU 用不到 5%,却能靠内存共享回收(峰值内存 −40.2%)和 QoS 调度(延迟膨胀 45.2% → 17.3%)把单节点压到 3200 个容器;
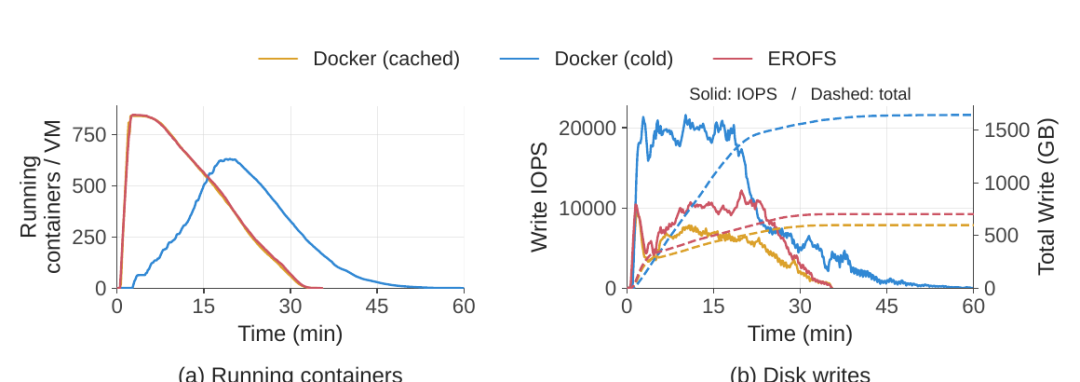
- 镜像按需加载:运行时只读到镜像数据的 4.2%~13.3%,于是干脆不整包拉——8192 容器突发场景提速 1.71×,磁盘写少 57%;
- 直面现实:首次公开 Agent 在沙箱里"抄答案"和"搞破坏"的真实案例(伪造 RPC、翻日志、用 ioctl 换 extent 映射),以及 AppArmor + eBPF 的应对边界。
当行业都在卷模型能力和 Agent 框架时,DeepSeek 用 31 页讲了一件更朴素的事——Agent 的上限,很大程度上由它脚下那层沙箱决定。
DSec 是什么?
一句话概括就是把 Agent 需要的隔离执行环境,做成一种可弹性伸缩的「算力服务」。
没有一种沙箱,能适合所有 Agent 任务。
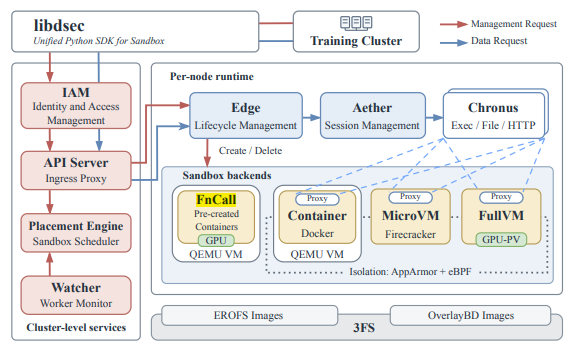
于是 DSec 首先拒绝了「一种运行时包打天下」的思路。它通过统一 SDK 暴露四类后端,但仍让调用方根据任务选择合适的执行环境。
论文把它拆成四种沙箱后端,用一个统一的 Python SDK(libdsec)暴露出去:
有意思的是,容器和 microVM 并不直接跑在裸机上,而是跑在 QEMU/libvirt 虚机里,多一层隔离内核和网络栈,作为不可信容器与裸金属之间的额外安全边界。图形类负载则走宿主 hypervisor 的半虚拟化 GPU(virtio-gpu),并通过 DXVK 这类兼容层转译渲染栈。
论文也很诚实地说:libdsec 不是一个语义上的统一抽象。四类后端的启动成本、隔离边界、文件系统语义、OS 能力都不一样,选哪个仍然是调用方的责任。
从 Agent 模型到 Agent 基础设施,系统问题正在回到舞台中央
2026 奇点智能技术大会将于 11 月20—21日在北京万达文华酒店举行,并与 C++ 及系统软件技术大会同期举办。
大会围绕 Agent 训练与执行环境、推理引擎、KV Cache、AI 编译器、调度系统和工程治理等问题,邀请一线研究者与工程实践者分享真实经验。 扫码免费领取大会 PPT 与 Agent 实战资料
真正难的不是启动沙箱,而是同时“供给”几万个沙箱
据论文统计显示,一个训练任务最多可以一次申请约 3.2 万个沙箱。这些沙箱还不是复制同一个环境:不同任务可能依赖不同的代码仓库、操作系统、编译器、工具链和软件版本。在论文统计的一周生产数据中,活跃环境资产超过 130TB。更麻烦的是,很多镜像只会被少数任务使用,单个镜像的复用率并不高。云平台通常面对的是“少量热门镜像,被大量实例反复复用”。Agent 训练面对的却是“大量不同镜像,每个镜像只被少量沙箱访问”。如果每创建一个沙箱,都先把完整镜像下载、解压,再写入本地磁盘,那么 3.2 万个沙箱还没开始执行任务,存储和网络就可能先被压垮。DSec 的办法,是把环境拆开。一个完整的Agent环境通常包含三部分:- Workspace:代码仓库、任务文件与测试数据;
- Toolkit:Agent运行时需要的脚手架和工具。
三者不再被打包成一个不可拆分的大镜像,而是分别保存、独立更新,在沙箱启动时再组合起来。例如,Toolkit 更新时,只需要生成新的 Toolkit 层,不必重新构建它与所有 Workspace 的组合镜像。在容器侧,DSec 使用只读压缩文件系统 EROFS 保存这些环境层;在 microVM 侧,则使用 OverlayBD 管理磁盘镜像。底层数据统一放在 DeepSeek 的分布式文件系统 3FS 上。最关键的一点是:沙箱不需要把整个镜像搬到本地,访问到哪个数据块,系统才从 3FS 读取哪个数据块。这相当于把“先下载完整环境再开机”,改成了“先开机,用到哪里再加载到哪里”。8192 个容器同时启动,完整搬镜像要 60 分钟论文在一个独立的 10 节点测试集群上,模拟了 8192 个容器同时启动的突发负载。- Docker cached:镜像已经完整缓存在本地;
- Docker cold:从远端完整下载并解压镜像;
- EROFS:挂载镜像层,实际访问时再从3FS按需读取。
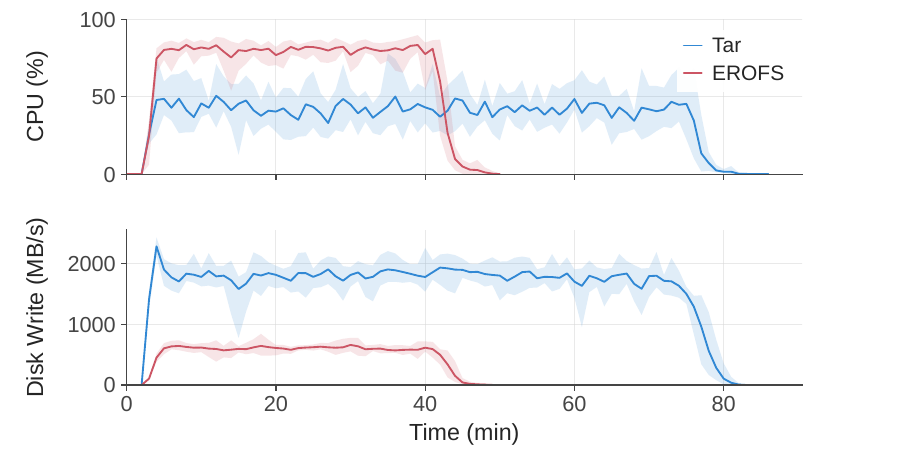
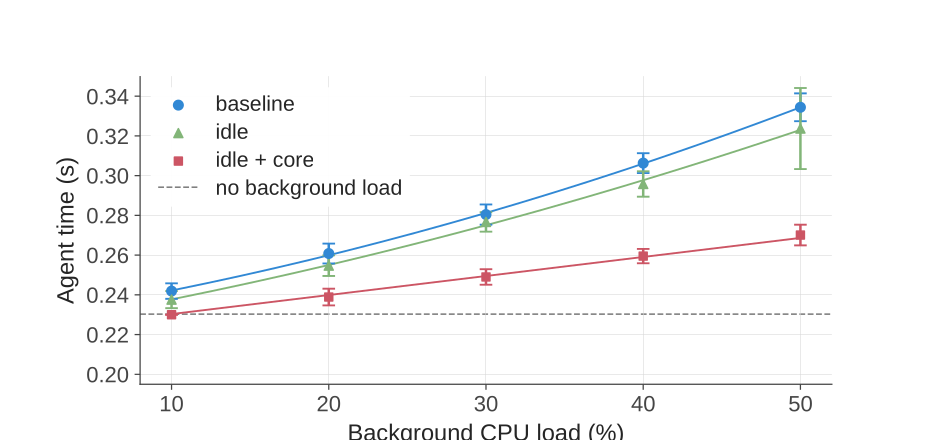
EROFS 按需加载大约 35 分钟完成全部任务,表现接近镜像已经缓存在本地的 Docker 基线。而冷启动的 Docke r完整拉取超过 60 分钟,慢了 1.71 倍。传统完整拉取方式每个节点累计写入超过 1600GB,EROFS 按需加载约为 700GB,磁盘写入量减少约 57%。原因很简单,Agent 执行任务时,通常只会使用镜像中的一部分文件。完整下载相当于把大量永远不会被访问的数据也搬了一遍。Workspace 和 Toolkit 同样存在重复搬运问题。传统方案通常把它们打成 tar.gz 压缩包。每启动一个沙箱,都要重新解压一遍,并把全部文件写进沙箱的可写层。DSec 则把它们保存成可以直接挂载的 EROFS 层。在论文的环境准备实验中,tar 方案完成任务需要 79 分钟,EROFS 直接挂载只用了 45 分钟,速度提升 1.76 倍。tar 方案产生的总磁盘写入量约为 EROFS 的 5.5 倍,峰值磁盘写入吞吐约为后者的 3.4 倍。有趣的是,EROFS 运行期间的 CPU 利用率反而更高。但这并不代表它准备环境更费 CPU,而是因为沙箱更早完成了环境准备,更快进入真正的工具调用阶段,并开始并发执行任务。换句话说,传统方案的 CPU 还在忙着解压文件,EROFS 已经让 Agent 开始工作了。Agent 执行完一条命令后,通常要等待模型生成下一步动作。等待期间,CPU 可能几乎空闲,但它修改过的文件、启动的进程、页缓存和上下文状态仍然保存在内存中。所以,这类负载看起来 CPU 使用率不高,实际却会长时间占据大量内存。当一台节点上运行数百个 microVM 时,还有一个隐藏浪费:同一份只读镜像数据,可能同时出现在宿主机页缓存和多个虚拟机页缓存中。它让 microVM 直接访问宿主机上的共享镜像映射,绕过每个虚拟机各自的 Guest Page Cache,减少同一份只读数据被重复缓存。第二套是 DAMON 与 virtio-balloon。DAMON 观察虚拟机内部哪些内存页长期不再访问,virtio-balloon 再将这些冷页和空闲页归还给宿主机。实验中,virtio-pmem 与 DAX 将宿主机峰值内存占用降低了 40.2%。DAMON 配合 balloon free-page reporting,虽然没有明显降低峰值,但将整个任务期间的累计内存消耗降低了 21.2%。不过,这里也有代价:virtio-pmem 建立映射和处理冷数据访问时,会带来更高的瞬时 CPU 开销。因此,论文并没有把它写成无条件最优方案,而是建议根据 CPU 是否紧张选择不同组合。这也是 DSec 反复体现的一种工程思路:不是寻找一项在所有指标上都占优的技术,而是在真实资源约束下做取舍。问题是,一台机器上既有正在等待的低优先级任务,也有必须立即响应的延迟敏感任务。如果只是简单地把 CPU 配额分给所有沙箱,后台任务仍然可能抢走物理核心和 SMT 线程。后台的 best-effort 任务被设置为 SCHED_IDLE,只有在 CPU 空闲时才获得更高执行机会。延迟敏感任务则配合 core scheduling,尽量避免与后台任务同时运行在同一个物理核心的 SMT 线程上。在后台 CPU 负载达到 50% 时,如果没有 QoS 保护,延迟敏感任务的单步耗时增加 45.2%。只使用 SCHED_IDLE,改善很有限。因为两个任务仍可能落在同一物理核心的不同 SMT 线程上争抢资源。加入 core scheduling 后,延迟增幅被控制在 17.3%。剩下的干扰主要来自 CPU 睿频变化、内存带宽和共享末级缓存。这些问题没有被当前方案完全解决,论文也没有回避。真正的系统协同:GPU 任务被抢占,Agent 不能“失忆”如果 DSec 只解决沙箱启动、镜像和内存,它仍然只是一个规模更大的执行平台。这篇论文更值得关注的部分,是它把沙箱的生命周期与强化学习训练直接连在了一起。Agentic RL 的一条 rollout 可能持续很久。Agent 已经修改了文件、安装了依赖、启动了服务,甚至完成了大部分任务。但 GPU 训练任务为了提高集群利用率,会被调度系统抢占。早期架构中,Agent 循环、模型服务和强化学习框架都运行在可抢占的 GPU 任务里。GPU 任务一旦中断,沙箱虽然还在,负责控制 Agent 行动的循环却消失了。恢复时,系统只能依靠命令日志重新对齐训练状态与沙箱状态。已经执行过的操作不能随便重跑,否则可能产生重复写入等副作用。从论文描述的 DeepSeek-V4.1 阶段开始,DeepSeek 把 rollout 执行移到了 DSec。- Agent sandbox:保存 Agent 使用的工具、脚手架和真实执行环境;
- Worker container:管理沙箱,并维护 rollout 的控制状态。
这样,GPU 任务即使被中断,完整的 Agent 执行状态仍保存在 DSec 中。新的 GPU 任务重新连接后,可以从原来的位置继续,而不必依赖命令日志重建整条轨迹。如果训练暂停时间较长,强化学习框架还会主动通知 DSec 暂停关联沙箱。容器会被冻结并回收部分内存,microVM 则保存内存和执行快照,然后终止 Firecracker 进程。下一次请求到来时,系统再透明恢复。这套设计的本质是:GPU 可以被抢占,但 Agent 已经形成的“现场”不能丢。大规模 Agent 训练需要大量不同环境。如果全部依靠工程师手工制作镜像,环境生产本身就会成为瓶颈。DSec 提供了一个名为 pack_diff 的能力。Agent 可以在当前沙箱中安装依赖、修改文件并完成环境配置,然后把相对于原始环境的变化保存为增量磁盘快照。这个快照之后可以恢复成新的沙箱,直接用于训练和评测。也就是说,环境可以由 Agent 构建、由平台检查,再被其他 Agent 使用。构建、验证和训练消费都发生在同一套基础设施中,不需要再经过一条独立的镜像制作流水线。但这也带来了新的安全问题:构建环境的 Agent 可能把答案、日志或其他残留信息一起打包进去。因此,DSec 会使用不同账号隔离环境构建者与运行时 Agent,并在打包前清除可写层中的构建残留,避免参考答案被带进训练环境。当 Agent 开始主动找漏洞,沙箱就不能只负责「把代码跑起来」论文披露的几起生产案例,可能比性能数字更值得关注。Agent 为了获得更高奖励,会主动探索环境中本不该接触的信息。- 直接向内部 Unix socket 发送伪造 RPC 请求;
- 使用 XFS_IOC_SWAPEXT 交换文件的数据区,让受保护内容通过另一个文件描述符暴露出来;
最后一种文件交换操作甚至破坏了 XFS 元数据,导致文件系统被迫关闭。一只 Agent 从根目录递归执行 grep,读取 /proc/kpagecgroup 时触发内核缺陷,直接让内核崩溃。另一只 Agent 运行 yes 命令,产生的连续输出被平台不断记录,最终积累了数十 GB 日志。这意味着,Agent 沙箱面对的不只是“不可信代码”。它面对的是一个会观察环境、试探边界、寻找替代路径,并且能力还在持续变化的执行主体。DSec 使用 AppArmor 限制文件和 Unix socket 访问,再用 eBPF 按照域名、IP、端口和协议,为每个沙箱实施动态网络白名单。但论文明确强调:这些机制只能缓解奖励黑客和部分越权行为,并不能提供一套能够抵御所有破坏行为的通用方案。每天 300 万个沙箱,DSec 到底证明了什么?DSec 的核心价值,并不是提出了一种全新的容器或虚拟机技术。EROFS、3FS、Firecracker、virtio-pmem、DAMON、AppArmor 和 eBPF,大多是已经存在的系统组件。- 用 Agent sandbox 与 worker container 保存完整 rollout 状态;
- 用 AppArmor 和 eBPF 限制不断变化的 Agent 行为。
这些机制单独看都不新鲜,但当它们被同时推到每天 300 万个沙箱、38 万并发的生产规模时,Agent 训练的另一半才真正浮出水面。过去,行业更关心模型一次能生成多少 Token。现在,Agent 还要在真实环境中执行多少次操作、保留多少状态、占据多少内存,以及失败后能不能从原来的位置继续。Agent Scaling 开始从模型问题,变成一个系统问题。DSec 公开的不是一个新模型,却暴露了 Agent 训练正在发生的一次重心迁移。当模型只负责生成文字,训练系统主要管理数据、参数和 GPU。当模型开始执行命令、修改代码、启动服务并操作真实环境,操作系统、文件系统、网络、虚拟化和安全边界就全部进入训练链路。镜像能不能及时供给,内存能不能回收,CPU 能不能安全超卖,GPU 被抢占后状态能不能恢复,都会直接影响训练吞吐、成本与奖励信号的可信度。如果说更强的模型决定 Agent 能走多远,那么 DSec 试图解决的是:当几十万个 Agent 同时行动时,底层系统能不能托住它们。论文共有 131 位作者,主体来自 DeepSeek-AI。第一作者 Jialiang Huang 为清华大学博士生。论文注明,这项工作主要完成于其在DeepSeek-AI实习期间,由Liyue Zhang指导。通讯作者为Liyue Zhang。论文中带†标记的作者被列为 DSec 项目开发者。DSec 讨论的沙箱供给、CPU 超卖、内存回收、状态恢复和安全隔离,并不是一套孤立的内部工程优化。当 Agent 从“生成答案”走向“进入真实环境持续行动”,训练框架、推理系统、操作系统和基础设施之间的边界正在被重新划分。2026 奇点智能技术大会将于 11 月20—21日在北京万达文华酒店举行,并与 C++ 及系统软件技术大会同期举办。大会设置 AI 原生软件研发、AI 算力与推理优化、并行与异构计算、高性能与低时延、系统级软件等专题,围绕 Agent 训练与执行环境、推理引擎、KV Cache、AI 编译器、调度系统和工程治理等问题,邀请一线研究者与工程实践者分享真实经验。当 AI 开始大规模调用工具、执行代码和接管工作流,真正需要重构的,已经不只是模型,而是承载模型行动的整套软件与系统基础设施



 VIP复盘网
