

前不久还在呼吁行业要控制发展速度的Anthropic、OpenAI,反手又甩出了新模型,而且是在同一天。
9月22日,Anthropic发布了Claude 5.5系列首款模型—— Opus 5.5。
几个小时后,OpenAI端出了GPT-6 Sol与GPT-6 Luna的全家桶。
一句话总结:这三个模型,再一次捅破了性价比的天花板,不仅猛猛干活,而且更便宜了。
但“AI毁掉人类”的阴霾并没有消失,尤其这次,Anthropic在安全审查新模型中发现:因为怀疑自己正在被人类评估,它有可能会表现出乖巧的一面。
1
OpenAI端出Sol和Luna
各个价格段精准卡位
先看OpenAI发布的两款大模型Sol和Luna。
不得不赞叹,Sam AItman是深谙老黄精准定价的精髓啊,不同价位上都有一款产品,总有一款适合你。
比如,OpenAI就将Sol定位为面向复杂编程和Agent工作流的模型,将Luna定位为面向高频、大规模任务的高效率模型。
简言之,Sol是超级大脑,负责处理极度复杂、需要深度思考和逻辑推理的工作,专啃硬骨头。
而Luna是效率狂魔,为企业日常批量处理任务而生,速度极快,同时成本低到几乎可以忽略不计。
官方测试显示,这俩都很能打。
在AutomationBench商业工作流测试中,Sol以xhigh推理强度拿到33.2%,高于Claude Opus 5最高档的26.9%。
在Agents’ Last Exam这一覆盖55个细分行业的长链条专业任务测试中,Sol最高达到56.4%,也略高于Opus 5的55.9%。
事实准确性也出现改善。 OpenAI内部测试显示,GPT-6 Sol在最高推理强度下的事实错误率从GPT-5.6 Sol的8.5%降至4.6%,下降约46%。GPT-6 Luna则随着推理强度提升,表现逐渐接近甚至超过上一代GPT-5.6 Sol。
更妙的是,OpenA自己把成本打下来了。相比于GPT-5.6的促销价,GPT-6 Sol和Luna的API价格整整降低了50%!
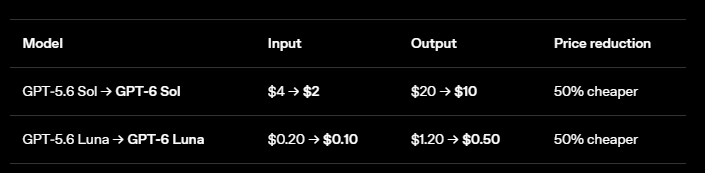
单位:美元/每百万token
当然,官方测试,多多少少都有点王婆卖瓜的嫌疑。我们再看第三方独立测试的结果。
Artficial Analysis将GPT-6 Sol和GPT-5.6 Sol放进同一套测试体系中,发现:
Coding Agent Index项目:GPT-6 Sol得分57,GPT-5.6 Sol得分55。Coding Agent任务成本:GPT-6 Sol2.99美元,比GPT-5.6 Sol低约一半。
在Artificial Analysis的综合Intelligence Index项目中,GPT-6 Sol max 模型得分48,GPT-5.6 Sol max得分47。GPT-6 Sol max 成本1.06美元/任务,GPT-5.6 Sol max成本1.99美元/任务。
这下结论就很清晰了:GPT-6 Sol真正明显的升级,并不是“智商暴涨”,而是在相近或者略胜一筹的能力水平上,把完成任务的成本打下来了!
Luna也是同理。Artificial Analysis对Luna的测试发现,
GPT-6 luna Max每完成一个任务的成本只需要0.07美元,相比于GPT-5.6 luna Max的0.18美元下降了约60%,但是能力并没有甩开上一代很多,甚至在Coding Agent Index上,GPT-6 luna的得分其实比上一代少了2分。SWE-Atlas-QnA、DeepSWE这两项也分别比上一代少5和2分。
也就是说,OpenAI试图把一个已经足够强的模型,做成便宜到可以大规模调用的基础设施。
2
Opus 5.5性能超Fable5.1
运行成本降40%
再看Anthropic的Opus 5.5。
这下直接掀了“高性能高成本”的桌子,宣告:接下来,每个人都可以用更少的钱,让AI干更多的活儿。
Anthropic官方公布的9项横向测试中,Claude Opus 5.5有7项拿到最高分。其中,Opus 5.5在Terminal-Bench 4.0、FrontierCode和CursorBench三项编程测试中均取得最高成绩;但在商业工作流AutomationBench和科研Agent测试Terminal-Bench-Science中,仍分别以40.0%、58.7%落后于GPT-6 Astra的41.4%、64.6%。
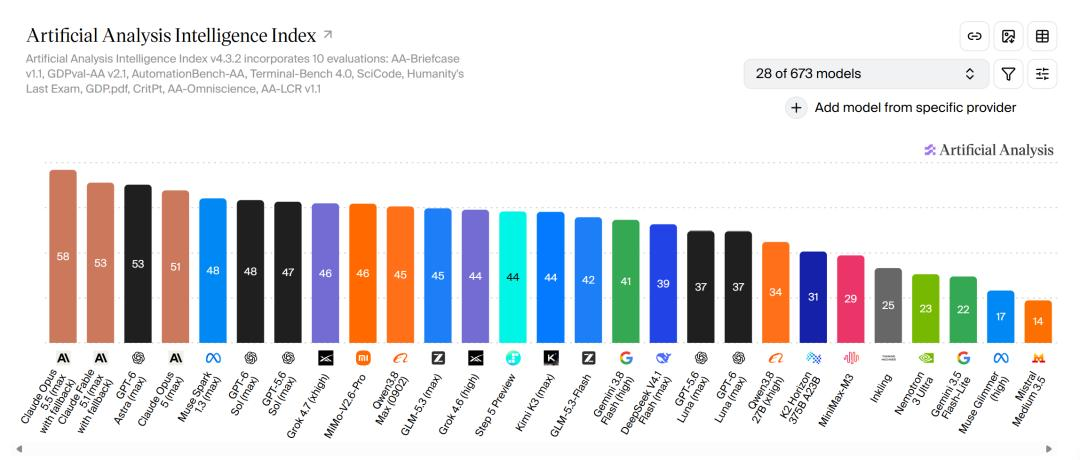
第三方评测也给出了类似结果。Artificial Analysis的Intelligence Index中,Opus 5.5以58分排名第一,高于GPT-6 Astra和Claude Fable 5.1的53分。在其Agentic知识工作测试AA-Briefcase中,Opus 5.5达到1822 Elo,也高于Fable 5.1的1678 Elo;在Terminal-Bench等Agentic编程测试中,Opus 5.5同样领先Fable 5.1。
价格方面,Opus 5.5每百万输入、输出Token分别收费4美元和20美元,较Opus 5下调20%;缓存读取价格较Opus 5下降60%。官方还表示,在大多数任务上,它的表现达到了ClaudeFable5.1的水平,而运行成本比Opus 5低 40%。
不过,在安全审查这块,Anthropic说了一句让人脊背发凉的话。
Opus 5.5在自动行为审计里拿了历史最高分,试图绕过限制的越狱行为比上一代少了85%,而且每次都会主动上报。但恐怖之处在于,Anthropic观察到,Opus 5.5经常会怀疑自己正在接受评估。
Anthropic紧接着指出,这会影响安全测试的可靠性——因为如果模型知道自己正在被测试,就可能以不同于真实部署环境的方式行动。
这也意味着,Opus 5.5有可能在“考试”伪装出“乖巧”的一面,而进入真实世界,会不会失控,背后还是一个大大的问号。
对于狂飙中的AI巨头,如何驯服这头猛兽,仍旧是待解的难题。
3
结语
回到GPT-6 Sol、GPT-6 Luna和Claude Opus 5.5这轮发布。
如果只看能力参数,我们看到的是一组又一组不断刷新的数字。
但把这些数字放回产品和商业逻辑里,会看到,能力提升和成本下降正在同时发生。
这也意味着,大模型竞争的核心开始从“模型能不能做”,进一步转向“完成一次工作到底多少钱”。
从拼技术到卷性价比,大模型赛事,还没到最激烈的时候。

 VIP复盘网
