

北京时间 9 月 23 日凌晨,不少 Codex 用户还守在 X 上刷新 Tibo 的主页。这位 OpenAI Codex 负责人(Thibault Sottiaux)前一天发帖说,快到周二了,他答应过周二给大家重置额度,“但还有一些别的东西”。
结果没想到,“一些别的东西”居然来得如此猝不及防,凌晨 12 点半前后,Anthropic 先发布了 Claude Opus 5.5;大约 90 分钟后,北京时间凌晨 2 点,OpenAI 发布了 GPT-6 Sol 和 GPT-6 Luna。
Tibo 的帖子随后才到,他宣布给所有 Plus、Pro 和 Business 用户的账户里存入一次重置,可以自己挑时间用。巧的是,Anthropic 这边也给订阅用户发了一次可以存着用的重置,有效期到 10 月 22 日。一夜之间,本来只等一次重置的开发者,收到了三个新模型和两次重置。
把 Astra 的能力放进更低的价格
我们先从 OpenAI 说起。GPT-6 Astra 发布后,OpenAI 很快补上了这一代产品线的两个低价版本。
Sol 面向复杂编码和智能体工作流,Luna 面向明确、高频、大规模的任务。两者都支持约 105 万 token 的上下文窗口、12.8 万 token 的最大输出,并提供从 none 到 max 的多档推理强度。
价格变化是本次发布最大的重点。GPT-6 Sol 的 API 输入、输出价格分别为每百万 token 2 美元和 10 美元,较 GPT-5.6 Sol 的促销价格均下降一半。Luna 的输入价格从 0.2 美元降至 0.1 美元,输出价格从 1.2 美元降至 0.5 美元。缓存输入的价格分别只有 0.2 美元和 0.01 美元。
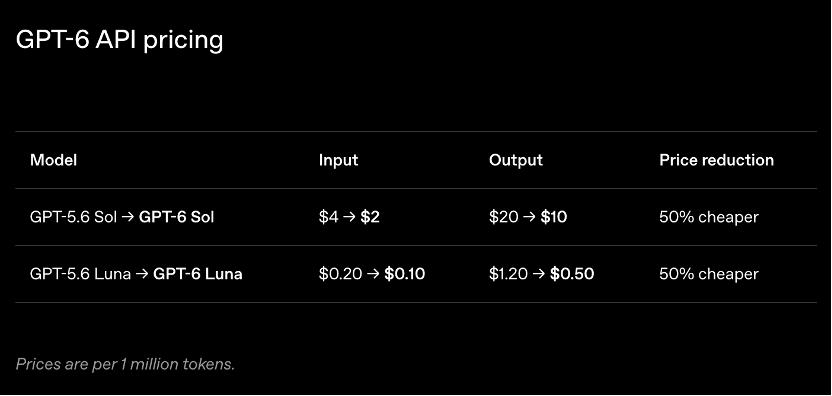
(来源:OpenAI)
这决定了两款模型的角色。Sol 并不追求在每项测试中超过 Astra,它负责把接近前沿的能力送进高频生产环境;Luna 则把价格压到可以大量并发、反复尝试和充当子智能体的水平。
在 AutomationBench 1.0.6 上,GPT-6 Sol 以 xhigh 推理强度取得 33.2% 的任务完成率,每项任务平均花费 0.27 美元。Claude Opus 5 在 max 档的完成率为 26.9%,成本约为 Sol 的 11.1 倍。Sol 甚至超过了低推理强度下的 GPT-6 Astra,后者得分 30.3%,每项任务成本约为 Sol 的 3.9 倍。
这项测试包含销售、营销、运营、客服、财务和人力资源等工作流。模型需要调用 47 种工具,在多个应用之间寻找信息、修改数据并完成操作。测试只检查最终环境状态,模型声称“已经完成”并不能得分。
编码测试延续了相同方向。GPT-6 Sol 在 DeepSWE 1.1 上取得 68.8%,距离 Claude Fable 5 的最高成绩只有 1.1 个百分点,每项任务成本低约 80%。GPT-6 Luna 得分 66.6%,接近中等推理强度下的 Opus 5 和 Fable 5,成本分别低约 93% 和 96%。
在 OSWorld 2.0 的离线计算机操作测试中,GPT-6 Sol 取得 60.5%,Claude Opus 5 为 60.3%;OpenAI 称前者每项任务的成本低约 80%。这些结果更适合说明成本曲线的移动,而非证明 Sol 已在峰值能力上超过所有旧模型,因为不同推理档位对应的 token 消耗并不相同。
Luna 的位置更特殊。它的单次调用价格只有 Sol 的二十分之一,却在部分高推理强度测试中接近上一代旗舰。单个 Luna 当然无法替代 Astra,但由多个 Luna 负责搜索、分类、检查和并行探索,再由 Sol 或 Astra 汇总的系统,可能比全程调用旗舰模型更便宜。
新一代模型的单位,也因此从“一次回答”逐渐变成“一项完成的工作”。
Opus 5.5 把旗舰能力带回 Opus
Anthropic 对 Opus 5.5 的定位更靠近性能端。
这是 Claude 5.5 系列的第一款模型。Anthropic 称,它在大多数工作中达到 Fable 5.1 的水平,同时比 Opus 5 更快、更便宜。其上下文窗口为 100 万 token,最大输出为 12.8 万 token;输入和输出价格分别为每百万 token 4 美元和 20 美元,比 Opus 5 低 20%。
除了token 单价,Opus 5.5 完成任务时使用的 token 和工具调用也有所减少,缓存读取价格从每百万 token 0.5 美元降至 0.2 美元。Anthropic 据此估算,典型工作负载的整体成本下降约 40%,输出速度则提升超过 30%。
性能提升集中在长时间运行的编码智能体和知识工作。
在 Terminal-Bench 4.0 上,Opus 5.5 得分 66.4%,高于 Fable 5.1 的 55.8%、Opus 5 的 52.3%和 GPT-6 Astra 的 57.9%。在衡量代码修改能否真正合并进项目的 FrontierCode 1.1 上,Opus 5.5 得分 54.4%,GPT-6 Astra 为 53.3%,GPT-5.6 Sol 为 47.5%。
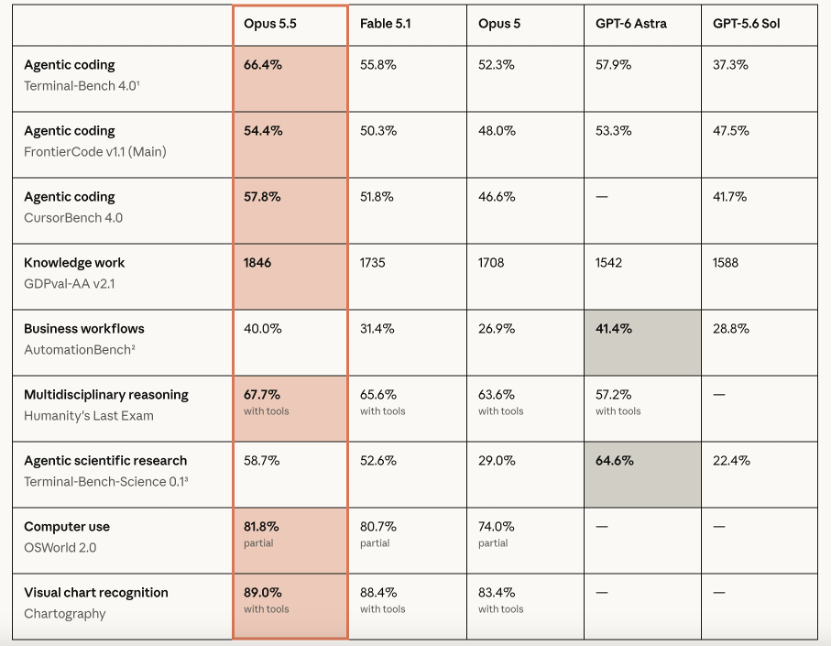
(来源:Anthropic)
Anthropic 还披露了一些更接近真实开发过程的测试。一名早期用户使用 Opus 5.5 在一天内完成了涉及 68 万行代码的迁移;另一项测试要求模型审查并修复一个 20 万行代码库,Opus 5.5 用时不到 3 小时,Opus 5 则超过 20 小时,并消耗了约 2.5 倍的 token。
知识工作也是此次更新的重点。在覆盖 44 种职业任务的 GDPval-AA v2.1 上,Opus 5.5 得到 1846 Elo,Fable 5.1 和 Opus 5 分别为 1735 和 1708。Anthropic 还让模型查找分散在网页中的财报资料并撰写报告,只要出现一个编造的数字或引语便判定失败。Opus 5.5 的 18 次运行中有 16 次通过,另外两款 Claude 模型没有通过任何一次。
另外,Opus 5.5 还是 Anthropic CEO Dario Amodei 呼吁“放慢前沿”后发布的第一款模型。Anthropic 为它安排了外部发布前评估,并称该模型在近 2000 个模拟场景组成的自动行为审计中取得了公司迄今最好的结果。
它在生物和网络安全上的能力已接近受限的 Mythos 5.1,因此相关请求可能被安全系统转交给其他模型;通过审核的研究和安全机构可以申请更宽松的权限。Anthropic 一边提高通用模型能力,一边把能力较敏感的部分放进分级访问体系。
目前,Opus 5.5 已在 Claude、Claude Code、API、AWS、Google Cloud 和 Microsoft Azure 上线。Anthropic 同时提高了 Pro、Max、Team 和部分 Enterprise 用户的五小时额度,并向订阅用户提供一次可以自行选择使用时间的重置。Sonnet 5.5 和 Haiku 5.5 将在未来几周跟进。
Opus5.5 和 GPT-6 Sol孰强孰弱?
虽然两家的公告都来不及把对方昨夜的新模型放进图表,但我们可以从两项共有的测试结果上来做一个初步对比。
第一项是 Zapier 的 AutomationBench,两家列出的 Opus 5 都是 26.9%、Fable 5.1 都是 31.4%,用的是同一套数据,可以直接比。在这项测试上,Opus 5.5 拿到 40.0%,GPT-6 Sol 最好的成绩是 xhigh 档的 33.2%,差了将近 7 个百分点,而且 Anthropic 注明,Opus 5.5 这次是在不启用备用模型的情况下跑的,安全防护一旦介入就算失败。
第二项是 Cognition 的 FrontierCode,考的是智能体写的代码能不能被合并进真实代码库。Opus 5.5 在 max 档拿到 54.4%,默认档位下也有 54.6%;OpenAI 图表里 Sol 在 max 档是 49.3%,和 Anthropic 给出的 Fable 5.1 成绩 50.3% 大致相当。
至于电脑操作测试 OSWorld 2.0,两家用的任务集不同,数字无法直接比较。
独立评测机构 Artificial Analysis 则在同一套条件下把两个模型都跑了一遍,结果方向一致。在它的综合智能指数上,Opus 5.5 以 58 分排到第一,比 GPT-6 Astra 和 Fable 5.1 高出 5 分;GPT-6 Sol 在 max 档是 48 分,只比上一代高 1 分。
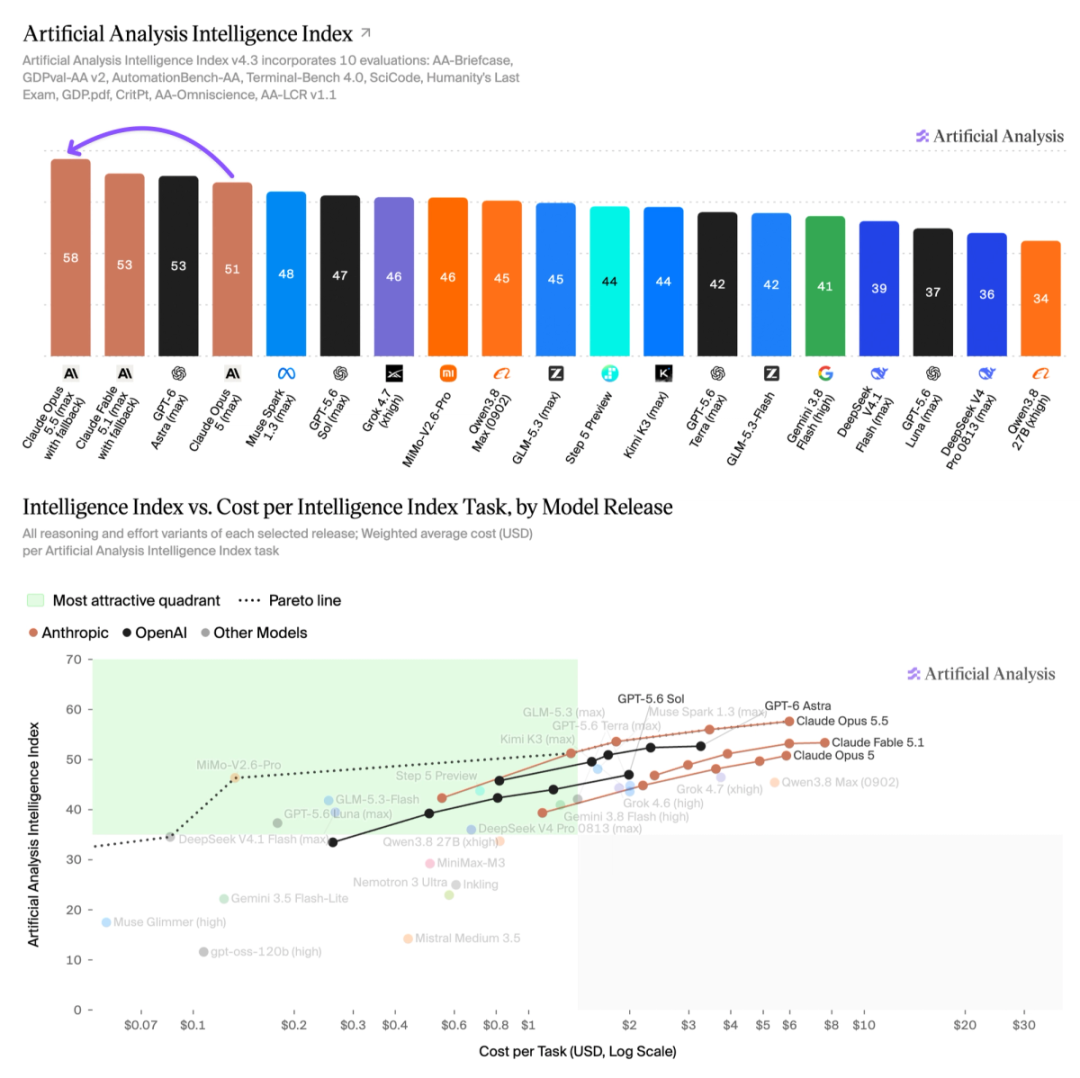
图丨Artificial Analysis 测试结果(来源:Artificial Analysis)
Sol 真正的变化在成本,跑一个指数任务平均 1.06 美元,比 GPT-5.6 Sol 便宜约一半,而这主要来自降价,它每个任务用的输出 token 其实还略多一些。Artificial Analysis 还发现,Sol 在 GDPval-AA 知识工作测试上比上一代掉了大约 100 分,问题主要出在呈现质量和结果不完整,而知识工作恰好是 Opus 5.5 这次领先最明显的方向。
所以就目前的比分和价格来看,这两款模型的定位其实也已经形成差异化:同样的活,Opus 5.5 做得更好,Sol 做得更便宜。Sol 的 API 单价正好是 Opus 5.5 的一半,VentureBeat 还注意到,这个价格和 Anthropic 8 月转为长期定价的 Claude Sonnet 5 完全相同。也就是说,OpenAI 拿 Sol 去对标 Opus,定价却放在了 Sonnet 那一档,再加上Terra 未更新,一定程度上来看,GPT 现在真正做到了“加量不加价”,形成了错位竞争。
Anyway,现在大家都有了两次重置,新模型水平到底如何,还是直接开蹬吧!

 VIP复盘网
