

作者丨胡敏
编辑丨刘伟
今年云栖大会,变化格外明显。参加过多年的人,打开主论坛议程就能感受到,和往年很不一样。
在吴泳铭发言之后,第一个登台分享的是千问大语言模型负责人刘大一恒;紧随其后的是ATH技术副总裁郑波,他负责视听等多模态模型。接在两场模型演讲之后,是平头哥高慧,与阿里云CTO李飞飞。
云栖大会,芯片和云当然重要,阿里对云的投入不会减少,芯片也依然是它绕不开的底牌。但重要的不止是芯片和云,现在站在市场聚光灯下的是AI,大家关心的自然也包括阿里的模型。阿里的模型往哪走、做多大、能不能打,是眼下真正牵动市场神经的问题。
那么,在云栖大会上,这些大模型负责人们究竟回答了哪些市场最为关注的问题?
01
Qwen下一代模型,规模有多大?
这是市场最直接的悬念。
此前一年多,业内对Scaling的质疑没停过。但到2026年年中,业界风向已明显调转。Anthropic CEO Dario Amodei在摩根士丹利会上直接定调:Scaling没有撞墙,2026年还会迎来一轮激进加速。
而从各家行动来看,也的确如此。
Fable 5 被行业估算为约4.5- 5 万亿参数,Kimi K3 总参数达到 2.8 万亿。这些数字接连落地,已经实实在在说明:各家Scaling 不仅没有停,反而在以比过去更激进的方式加速。
回到Qwen本身。今年 8 月,Qwen3.8发布,模型的参数已经达到了2.4T参数。这次云栖大会演讲上,刘大一恒再次给出了一张模型规划的路线图:Qwen4系列即将到来,Qwen4之后的Qwen4.5和Qwen5,计划进一步迈向5T—10T参数。
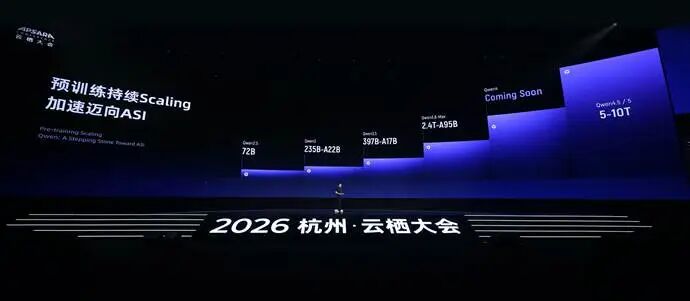
从72B到10T,千问的Scaling曲线正在明显变陡。
两年前,Qwen2.5旗舰模型的参数量还是72B;到Qwen3.8,模型已经扩大至2.4T,增长了33倍。如果Qwen4.5和Qwen5继续迈向5T—10T,千问的参数规模还将在现有基础上再扩大一倍至三倍以上。
刘大一恒也再次明确了阿里的判断:基础模型的智能上限,依然离不开算力、数据和模型规模的持续投入。阿里还会继续扩大预训练计算量,沿着Scaling Law向上走。
但模型越大,训练和推理的账单也越高。阿里给出的解法,是一边扩大规模,一边重新设计模型架构。
Qwen3.8-Flash已经展示了这条路线:通过稀疏注意力、线性注意力和外接记忆等新架构,它每次推理只激活6B参数;相比上一代,训练成本降至九分之一,百万Token的输入价格降至四分之一,超长上下文的预填充吞吐量提高8.6倍,模型能力反而继续上涨。
这意味着,阿里下一阶段的Scaling并不只是把模型做得更大,而是要用更低的成本,支撑更大的模型继续向前。
02
Qwen5还要等多久?
关心完规模,下一个问题自然就来了:Qwen4、Qwen5还要等多久?
当下模型竞争的节奏越来越快。今天登上榜首的模型,几周或几个月后就可能被追平。对模型公司来说,一个版本领先已经很难形成长期优势。真正重要的问题变成:谁能更快地产生下一代模型。
而要提升迭代速度,一个越来越被认真对待的方向是:让模型参与造模型。
一旦模型能帮助研究人员设计实验、分析结果、改进训练方法,那么下一代模型的研发就有机会更快。再让更强的新模型接着做这些工作,便可能形成一轮轮加速的循环。这也是RSI(Recursive Self-Improvement,递归自我改进),今年受到前沿实验室集中关注的原因。
Anthropic、OpenAI 在这件事上已经开始有了具体成果。此前,Anthropic做过一个实验:给Claude一段训练小模型的代码,让它自己找办法提速。它会改代码、跑实验、看结果,再接着改。去年,Claude把这段代码提速到原来的3倍;今年,最新模型已经能做到52倍。人类研究员花上半天,通常只能做到4倍左右。
OpenAI也在做类似的事,把模型用在了“找模型的漏洞”上。他们训练了一个专门攻击其他模型的GPT-Red,让它不断想办法诱导模型犯错;再把这些攻击样本拿去训练下一代GPT。结果是,GPT-5.6面对最难的一类提示注入攻击时,失败率比四个月前的模型低了约六倍。
回到阿里大模型。想了解Qwen4、Qwen5何时到来,或许也可以从阿里在RSI上的研究进展里找线索。
与上文提到的Anthropic、OpenAI 做的两件事不同的是,阿里做了一个实验:让Qwen不只调用工具,也开始参与建设自己的技术栈,把RSI带到了模型研发的底层环节。
最典型的一个实验发生在芯片设计上。
研究团队只给了Qwen3.8-Max一份真实的片上网络(NoC)模块规格,没有参考代码,也没有现成测试样例。接下来的60多个小时里,模型自己调用EDA工具,完成从编写电路描述、验证,到后端物理实现的一整套流程,期间没有逐轮人工介入。最终,芯片物理面积减少了42%,功耗估算下降59.5%。
同样的尝试还出现在推理基础设施上。
众所周知,国产芯片落地,难点不只在硬件能不能造出来,也在软件生态能不能快速迁移。长期以来,CUDA将模型、算子、框架和工具链紧密地绑定在英伟达芯片上。一块国产芯片从“能跑”到“跑好”,往往还要经历一轮漫长的适配。
梁文锋此前就提到,国产硬件首先要解决的是生态问题。他认为,TileLang等更高层的编程方式正在提供一个新的机会:开发者不必再逐行重写复杂的CUDA代码,而可以用更少的代码重新实现底层算子。DeepSeek内部甚至已经开始探索用AI编写TileLang。
类似的变化,也出现在阿里这次公布的实验中。面对一款此前从未适配过的平头哥新GPU,Qwen3.8-Max自己修改和优化SGLang推理框架,用56小时完成部署,将日常对话场景的单实例吞吐量提高了96%。
过去,国产芯片的软件生态要靠工程师一点点补;现在,模型开始亲自参与这项工作。
至于模型训练本身,阿里披露,Qwen3.8-Max曾连续自主运行一个多月,完成33轮有效实验:自己搭流程、构造数据、设计实验、定位缺陷,并推动模型继续更新。
当然,现在“模型自主造出下一代模型”当然还有距离,但它呈现出的方向已经很清楚:模型竞争不再只是比谁发布了一个更强的版本,也开始比谁能让模型更深地进入训练、推理、芯片这些研发环节,把下一代模型更快做出来。
03
多模态,阿里做到哪一步了?
前两部分聊的是Qwen。但阿里的模型战略,不只有语言模型这一条线,郑波带领的多模态,也备受外界关注。
市场期待的生成视频模型新版本,在这次大会上,郑波给出了一个明确时间:下一代视频生成模型将在11月亮相。
郑波将视频生成的下一阶段称为“Agent Video”。过去的视频模型,解决的是能不能生成一段足够逼真的画面;随后,图片、视频、声音等参考信息被加入进来,让生成结果变得更加可控。下一步,模型要做的不只是生成一个个素材片段,而是理解创作者到底想讲什么。
用户给出一个想法,模型自己拆解剧情、设计分镜、安排人物和场景,最后生成一段完整的视频。按照郑波的说法,新版本将沿着四个方向继续推进:更长、更可控、更完整,也更智能。
除生视频模型外,图像、语音、音乐、世界模型也有了新的升级。
图像生成模型Qwen-Image-3.1亮相,它面向电商、创意、设计等真实商用场景全新优化升级,将原本数小时的视觉设计压缩至秒级交付,水准堪比专业设计师,还支持图像精准编辑。
语音模型方面,阿里发布Qwen-Audio-3.1系列语音大模型,语音转写(ASR)、语音合成(TTS)和实时语音交互(Realtime)三类模型全面升级。其中,Qwen-Audio-3.1-Realtime实时交互能力再提升,能够边听、边想、边说,并进一步增强多语言交互、角色扮演和共情能力,目前,该系列模型已应用于千问办公和Qoder,并接入QwenNote A2随身助理、QwenNote Eva桌面机器人和千问AI眼镜等硬件产品。
音乐生成模型HappyShrimp1.1版本发布,在音乐表现、人声质量、多语种演唱及指令理解四个专业维度进一步提升,支持百余种曲风与十余种主流语言,覆盖人声歌曲与纯音乐两大生成场景。
世界模型HappyOyster也公布了2.0 Preview版本。新版本开始更准确地模拟物体运动和碰撞,通过3D时空记忆保持场景稳定,同时进一步降低交互延迟。阿里还联合高校和产业伙伴搭建世界模型Benchmark和Arena,试图为这个尚处早期的方向建立一套共同的评价标准。
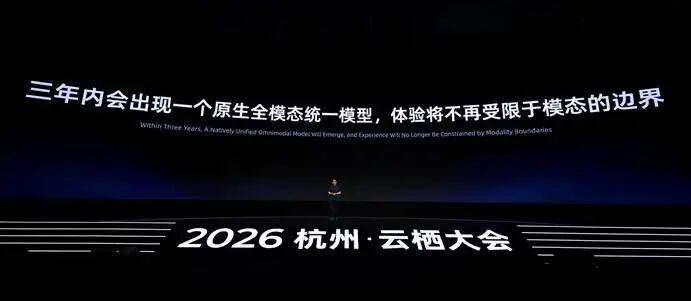
对于多模态未来的发展趋势,郑波在演讲中给出了一个更远的判断:三年之内,行业可能出现原生的全模态统一生成模型,这个可以同时生成图像、视频和音乐,也能够理解空间和世界。
总结来看,这次云栖大会,阿里把外界最关心三个模型问题摆上了台面:下一代Qwen还要做多大,模型迭代还能多快,多模态能不能打。
三个问题看似分散,拼在一起,却勾勒出了阿里下一阶段更清晰的模型路线:一条路仰望星空,追逐 AGI 的边界;一条路俯身泥土,抵达 AI 普惠的日常。两条路看似背道而驰,却最终汇于同一个北极星——让更高的智能走出实验室,落进现实世界,成为更多人触手可及的生产力。
未来,机器思考总量将是人类的1000倍,阿里为此迈出了坚实的一大步。

 VIP复盘网
