阿里最新图像模型开源!视觉生成部分仅7B,能生透明图、能改图
时间:2026-09-21 10:04
上述文章报告出品方/作者:智东西;仅供参考,投资者应独立决策并承担投资风险。
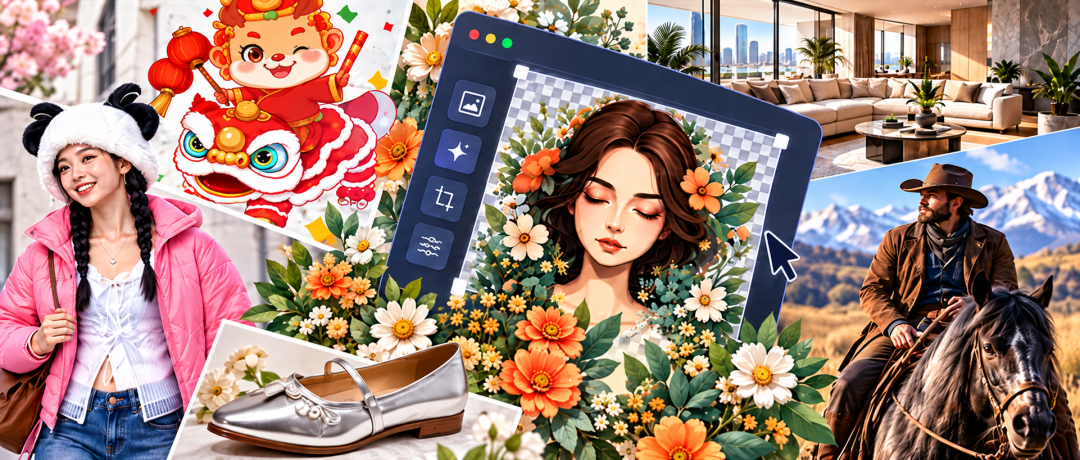
智东西9月21日,昨晚,千问开源图像模型Qwen-Image-2.1。该模型将文生图与图像编辑整合在同一模型中,视觉生成部分仅包含7B参数,并原生支持透明图像生成与编辑。从实际功能来看,模型通过轻量结构与推理优化,在保证生成质量的同时,保持较低的计算成本。模型最多支持10张参考图输入,可用于多主体合成和多种局部编辑,并尽量保持人物和商品的原有特征。此外,模型还调整了文字排版、人物光影和图像细节,让生成结果更贴近实际设计需求。官方公布的Qwen-Image-Bench评测显示,该模型以7B视觉生成模块取得60.28分,位列开源模型第一,超过Nano Banana 2.0、GPT Image 1.5等闭源模型,落后于GPT Image 2、Grok Imagine 2.0等模型。▲Qwen-Image-Bench公开评测对比(图源:千问大模型)
这次开源距离Qwen-Image系列上一次开源已过去约9个月,上一次是去年12月开源的Qwen-Image-2512。在闭源的Qwen-Image线上,千问图像模型已于今年7月更新至Qwen-Image-3.0版本。https://github.com/QwenLM/Qwen-Image-2.1https://www.modelscope.cn/models/Qwen/Qwen-Image-2.1https://huggingface.co/Qwen/Qwen-Image-2.1
Qwen-Image-2.1参数规模较小,视觉生成部分包含32层Single-Stream DiT(单流扩散Transformer)架构,参数量为7B。在较小的模型规模下,Qwen-Image-2.1依然保持不错的图像生成质量。在Qwen-Image-Bench公开评测中,它以7B参数的视觉生成模块,取得了与闭源模型近似的水平,得分60.28,领先Nano Banana 2.0、GPT Image 1.5等模型。在推理结构上,模型优化推理效率,采用混合粒度注意力结构。模型对文本和图像采用不同的处理策略:文本部分,系统前缀和编辑指令使用Token级因果掩码;图像生成部分使用Chunk级掩码。同时,模型还使用KV Cache复用机制,将输入图像和编辑指令作为静态上下文,在首步完成预计算并缓存,以提升推理效率、降低显存开销。▲Qwen-Image-2.1混合粒度注意力结构(图源:千问大模型)
透明图像是Qwen-Image-2.1此次更新的重点能力之一。模型可以根据提示词自动判断输出普通图像或带透明通道的图像,可以生成单个主体,也能生成由多个元素组成的复杂透明素材。在编辑场景中,用户可以保持透明背景不变,只修改主体的表情、颜色或其他局部细节。透明图层中的文字也能被直接替换,例如将图层中的“BLOOM”修改为“Qwen-Image”。在修改文字的同时,其他部分基本没有发生变化,文字也能根据实际情况调整大小。对于真实照片,Qwen-Image-2.1可以从RGB图像中提取指定主体,并输出带透明通道的RGBA图层,方便后续用于平面设计、商品合成和内容制作。模型可以提取出照片的前景树叶,形成透明的素材,删除背景中的建筑物等内容。
Qwen-Image-2.1最多支持10张参考图输入,具备多种局部编辑方式、人像与商品一致性增强,并覆盖多种类型编辑任务。在多人合照场景中,模型能够将多张人物照片整合到同一画面。输入六个人物照片后,模型可以将他们整合成一张合照,调整人物姿势、画面光影等细节,让整个画面保持自然。在服装搭配场景中,用户可以输入模特、衣服、鞋子、包包和帽子等图片,生成完整的穿搭效果。成图以街拍画面为基础,将粉色短款外套、黑白毛绒帽、棕色包和银色鞋子自然融入模特的整体穿搭中。在室内设计场景中,模型参考10张家居图片,完成整体空间布置。模型参考了走廊、沙发、餐桌、单椅、时钟、地毯、绿植等多张家居图片,将不同家具和装饰元素整合到同一间客厅中。局部编辑方面,模型支持圈选、涂抹和独立掩码三种方式。用户可以在图像中圈出多个区域,并分别提出修改要求。下面这个例子中,要求模型“去掉蓝色圈的金属手表,把红色圈的头发颜色改为黑色,把绿色圈替换为灰色短袖亚麻睡衣”,模型能够精准对这三个区域进行修改编辑。模型还支持涂抹指定位置修改。这个案例中,在原图鲨鱼右侧进行了白色涂抹,模型在这块白色区域添加了一名潜水员。如果希望尽可能保留原图内容,用户还可以将原图和独立掩码作为两张图片输入,由掩码明确指定需要修改的区域。输入原图后,把需要添加的马仔人物以掩码的形式输入,模型可以结合这两张图片输入,形成一张人物骑在马背上的图片。
千问称,Qwen-Image-2.1增强了人像编辑中的面部细节还原能力,能够在修图前后保持人物特征的高度一致。模型可以根据一张自拍,生成人物在竹林中的全身照,并修改人物服饰。进行多次调整后,人物的面部细节,仍与输入图像人物特征基本一致。在商品编辑中,模型重点保持商品的文字、纹理和外形,使商品置于新场景后仍能保留原有特征。这类能力可用于电商展示、广告素材制作和商品视觉设计。从官方案例来看,输入手串商品图后,模型基本保留了手串的整体结构、配色和材质,并将其放置到人物佩戴的场景中。不过,成图中的黑色珠子尺寸略大,与原图相比仍存在细微差异。模型还覆盖全景图、信息图和分镜图生成等任务。例如,输入一张自拍照后,模型可以将其扩展为全景。在可视化工具中,用户可以从不同视角查看场景,天空、云层、树木、街道等细节基本符合物理规律。输入模特照片后,模型可以生成内容丰富的复杂信息图,展示人物档案、配饰细节、服饰细节、风格关键词等信息。模型还可以根据人物三视图,生成完整分镜,为故事创作和视觉叙事提供素材。在图像质感方面,Qwen-Image-2.1进一步优化了文字生成、字体选择和版式布局。模型能够生成包含大量图片、文字、图表等多种信息的论文界面。成图中文字清晰,内容未出现明显错乱,整体排版较为合理,页面结构也保持美观。在人物表现上,Qwen-Image-2.1增强了光影与细节表现,使画面更接近真实摄影和商业设计效果。
Qwen-Image-2.1在7B视觉生成模块的基础上,把透明图像生成、透明图层编辑、多图输入和局部修改能力放进同一套模型,进一步降低图像创作门槛。对于设计、电商和内容制作场景,透明图像和多图编辑可以减少抠图、合成及反复修改的步骤。模型最终能否在本地部署成本、生成速度和复杂编辑效果之间取得平衡,还需要结合实际体验和开源社区反馈进一步观察。




 VIP复盘网