

当摩尔定律逼近物理极限,单颗芯片的竞赛正在让位于系统效率的竞赛。
华为今年提出的"τ定律",把优化目标从"晶体管做小"扩展到"信号跑快"——计算、存储、互联、供电、散热协同设计,比拼的是整个系统的有效算力。
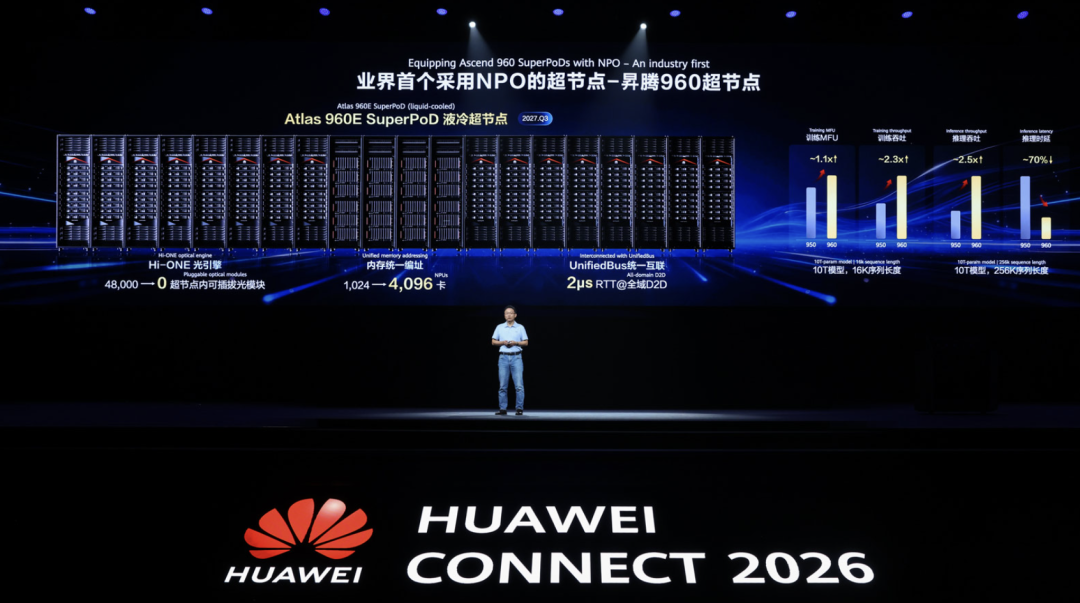
1、昇腾960芯片:华为下一代AI训练/推理芯片,研发进度全面超预期
昇腾960(Ascend 960)芯片是华为在26年的全联接大会上,推出的新一代AI算力芯片,分为昇腾960DT(AI训练)和昇腾960PR(AI推理)两个版本,旨在为十万亿参数大模型提供算力底座。
采用SIMD/SIMT双编程模型,支持FP8/FP4/HIF4等低精度格式,采用N+2/N+3工艺及多Die封装,实现算力与带宽的翻倍。并且首次实现288GB超大HBM容量,有效解决大模型内存瓶颈。
(1)技术壁垒:
① 先进制程受限下的架构创新——用FP8/FP4低精度规格、288GB HBM堆叠与9.6TB/s访存带宽的组合抢"有效算力",把单芯片竞争改写为"芯片+封装+互联"的系统竞争;
② 提前三个季度的时间壁垒——AI基础设施投资以年为单位,芯片能否按期出现会沿光模块、液冷、电源、数据中心逐层传导。对一条仍在建立市场信任的国产路线而言,"提前三个季度"比"参数漂亮"更值钱:这是国产算力第一次"抢跑",而不是"追赶"。
(2)后续路线:
坚持"一年一代",2028年推出昇腾970、2029年推出昇腾980,依托τ定律实现算力规格继续翻倍——据大会现场资料,970规划约3.6 PFLOPS FP8 / 14 PFLOPS FP4,980规划约7.2 PFLOPS FP8 / 28 PFLOPS FP4。
2、960超节点(系统级应用):把4096张卡拧成"一台计算机"
(1)超节点不是普通集群
传统AI集群由许多服务器通过网络连接:每张卡都有本地显存,跨服务器访问数据要经过网卡、交换机、协议栈与软件同步,卡越多,通信越容易成为训练瓶颈。
超节点(SuperPod)的思路是把大量物理服务器重构为一个逻辑计算域,即多个计算节点通过高速互联紧耦合、共享统一内存地址、在逻辑上形成"一台计算机"的系统。
多张NPU共享更统一的地址空间; 计算、显存与网络协同调度; 对大模型来说,更像在一台“超级主机”上训练,而非让数千台服务器相互发消息。
3、灵衢协议:让4096张卡“像一台机器”协作的底座
灵衢(UnifiedBus)是华为2025全联接大会发布、面向AI超节点SuperPoD的全栈自研互联协议,作为超大规模算力集群统一通信底座。它跳出PCIe、NVLink、以太网分立的传统路线,以一套归一化协议打通芯片、整机、机柜三层互联。
NVLink仅局限单柜芯片互联,以太网擅长跨集群组网,三者相互割裂;而灵衢从架构上消除板内、框内、跨柜的协议壁垒,是昇腾Atlas超节点标配底层总线。
灵衢是硬件规范 + 固件 + 系统软件 + 上层应用全栈体系,其核心特点
统一协议:尽量减少跨服务器、跨设备的协议转换和软件开销; 统一内存编址:让分散在不同节点的HBM更接近一个大内存池;
近铜远光:短距离采用铜互连控制成本与时延,较远距离采用光互连突破距离、带宽与功耗限制;
多平面网络:通过多轨道、多平面网络提升总吞吐并避免单链路拥塞;
故障可感知:链路闪断、设备掉卡、光路异常需要快速发现、隔离与重路由。
4、Hi-ONE与NPO:光为何要靠近芯片
(1)三条光互联路线
昇腾960是全球首个采用NPO光引擎的超节点,NPO(Near-Package Optics,近封装光学),把光引擎从机柜前面板搬到主芯片50毫米以内、独立封装。
NPO不是CPO的简单替代,而是高速互联从“可插拔”走向“共封装”的过渡与并行路线:它先缩短最耗能的高速电连接,又尽量保留光部件可测试、可维护的工程可行性。
业界三条路线的区别,本质是"光引擎离芯片有多近",下表是对比&区别
Hi-ONE有三个"业界第一":
业界首个量产的NPO产品; 行业目前最大传输能力:单引擎总容量7.2T(据机构拆解,海思硅光版采用36×200G架构,一颗约顶9颗800G可插拔模块,下一代规划到14.4T); 唯一实现内置光源的NPO产品——免外置光源模块,可靠性更高。
昇腾960超节点用5500个Hi-ONE,替代原本需要的4.8万颗800G光模块——光器件数量减少88%,采用线性直驱方案(无重型DSP),功耗降低约65%,系统无故障运行时间提升一倍。
5、液冷:4096卡量产的“物理前提”
昇腾960采用NPO架构,光引擎紧贴NPU芯片,局部热流密度成倍上涨,传统风冷已无法满足高密度集群的散热上限和PUE(电能利用效率)要求,全液冷成为保障系统性能、稳定性和寿命的刚需。
为匹配超节点分批上线的建设模式,昇腾960配套采用预制撬块冷站(预制冷源)。该模式为工厂整体预制、出厂测试,现场仅需水电对接,具有占地小、交付快、水力系统标准化、方便分期扩容的优势,完美适配高密度液冷算力集群的快速上线节奏。
6、3D数据中心:把机房"叠"成算力工厂
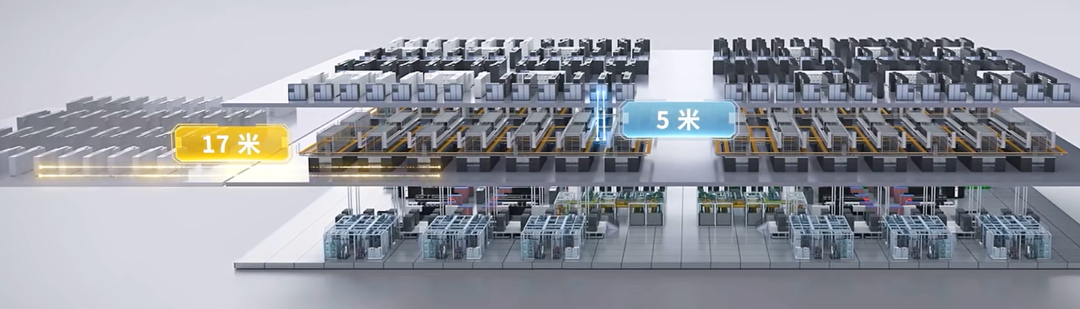
9月17日,华为在安徽芜湖点亮全球首个3D数据中心——借鉴芯片工厂"动力层与生产层严格分离"的理念,通过“分层解耦、立体堆叠”的全新设计,自下而上形成供冷层—IT设备层—供电层—备电层的四层垂直堆叠结构。
打破了传统数据中心“大平层”的平面布局,旨在解决AI算力爆发背景下,打造更高密度的部署,更高效率的能源利用,以及更智能的运维体系。
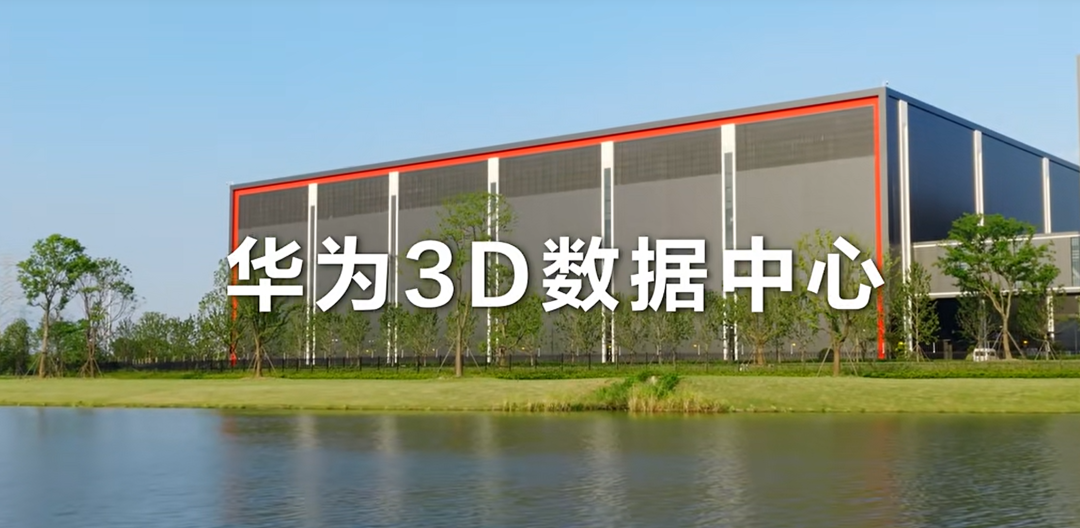
华为3D数据中心将传统水平铺开的功能空间垂直叠加,形成从下往上的四层立体架构。下图:四层垂直堆叠
(1)供冷层(底层):集中部署全域液冷供冷设备包含了水力模块、液冷一次管路、液冷二次管路、CDU、通过垂直短距散热路径为上层算力设备提供高效散热,实现分区精准控温。
(2)IT设备层(中间层):核心部署AI算力设备(如昇腾超节点),是数据中心的核心算力输出载体,设计上采用分层解耦,同层池化的机房布局。其“网络居中”架构以缩短信号传输距离。
(3)供电层(中间层):集中布置供电模块与配电设备,紧邻算力层,通过垂直供电缩短电力传输距离,降低线路损耗。
(4)备电层(顶层):将电池模组等备电设备独立部署于屋顶,实现物理隔离,提升储能安全防护。
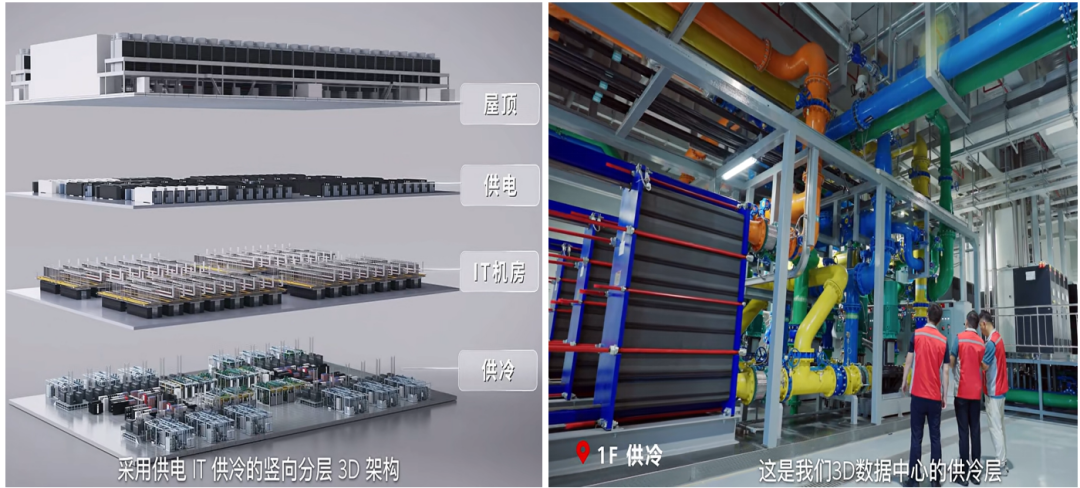
华为巧妙的采用供电IT 供冷的竖向分层3D架构,搭配16米大跨度空间尺度,结合垂直供冷、垂直供电、打造极短传输链路,用3D立体空间为高密算力铺平道路。
将供电和供冷,分别设置在IT机房的上下层,这样电力模块到机柜的平均距离,从传统的17米缩短到现在的5米,低压母线成本骤降70%,超过90%的机电系统。
在工厂模块化预制,运抵现场即可进行标准化组装,使POD机电交付仅3个月;同时支撑最小4组微模块,分期产品化快速部署,大幅降低了TCO(总拥有成本)。
二、与英伟达对比:单芯片差一代,系统掰手腕
英伟达当前最新/下一代主力:2025年Blackwell Ultra(GB300)、2026年H2的Vera Rubin NVL144、2027年H2的Rubin Ultra NVL576,以及Quantum-X/Spectrum-X Photonics CPO交换机。其最大护城河仍是CUDA/CUDA-X、开发者与全球供应链。
下表,正面对比图:
以下是个人三个判断,不代表企业真正实力:
判断一:单芯片仍差一到两代,这是"硬约束"。 960DT单卡FP4约4 PFLOPS,对Rubin的50 PFLOPS,差距约12倍;制程、HBM代际、单卡能效的差距客观存在,短期内无法靠设计完全抹平。
判断二:超节点规模算力,华为已站上第一梯队。 8 EFLOPS FP8 vs NVL576的5 EFLOPS FP8、16 vs 15 EFLOPS FP4——用约7倍的芯片数量换来同量级的系统算力,代价是功耗、占地与成本。这就是"以联补算、以柜换卡":单点追不上的,体系追。
判断三:光互联是一次罕见的"抢跑"。 英伟达的CPO交换机(Quantum-X 115Tb/s、Spectrum-X 409.6Tb/s)2026年起落地,但CPO大规模上机要到NVL576(2027年);华为NPO光引擎2026年即随超节点量产。CPO极限性能更高(1.6T模块功耗30W→9W,能效3.5倍),NPO良率与可维护性更优——光互联路线上,中国第一次和对手"同步起跑,甚至先半步落地"。
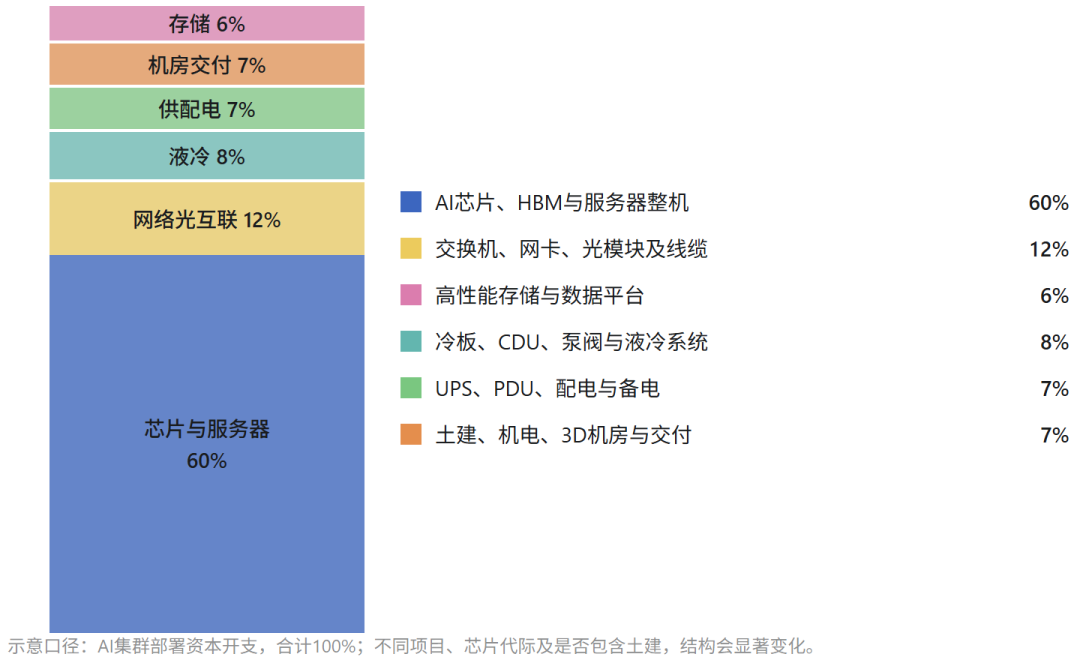
三、产业链&价值占比
华为的昇腾960超节点,产业链上游是芯片、原材料与核心部件;中游是超节点系统组装& IDC基建;下游是算力服务的行业应用落地。
上游决定“能不能造”,中游决定“能不能稳定跑”,下游决定“能不能变现”。
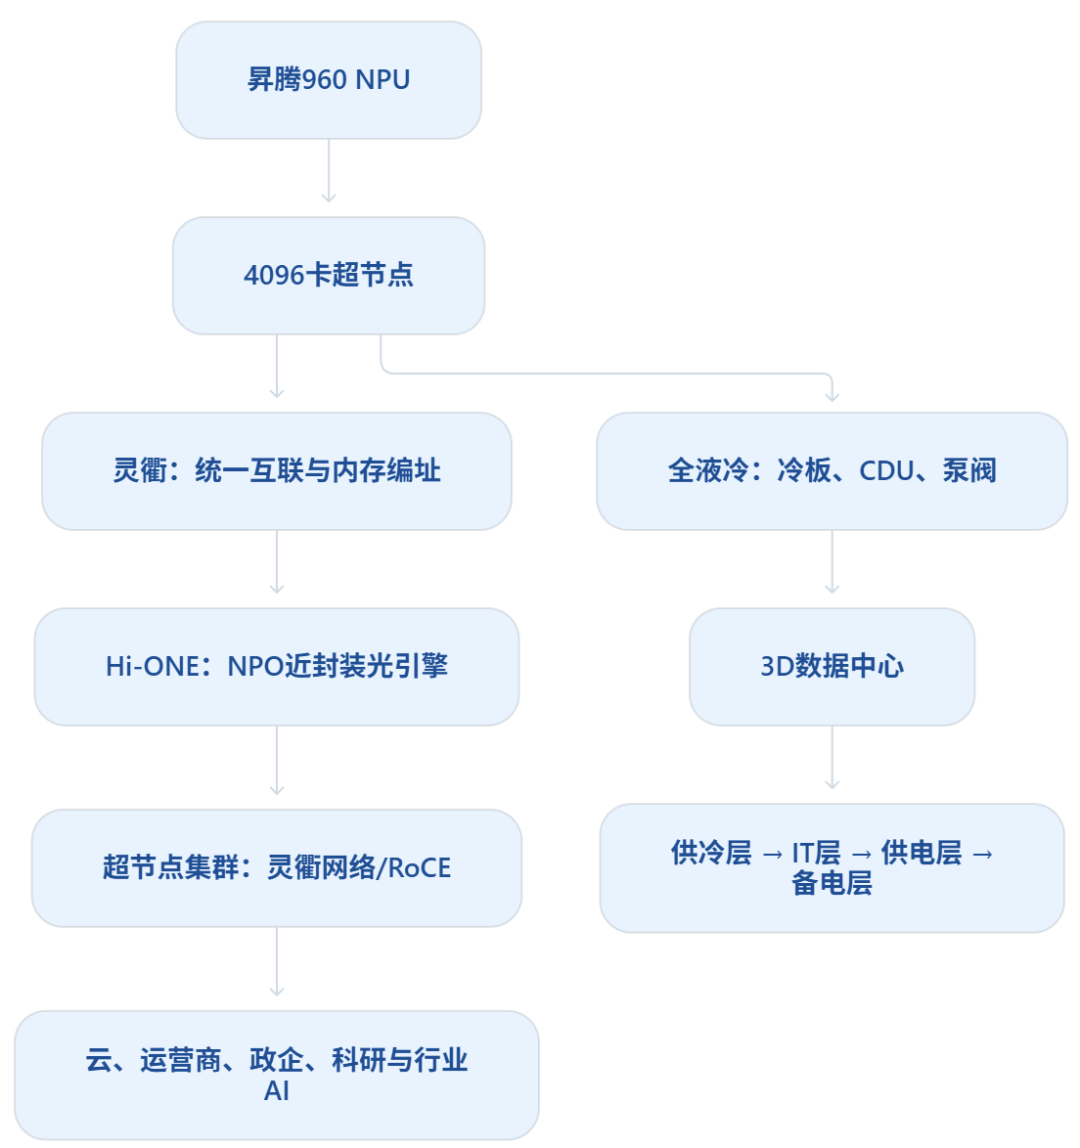
(1)芯片端:包括NPU昇腾960系列(如960DT、960PR)、HBM、晶圆制造和先进封装,难点在于算力、功耗、良率与散热的平衡;
(2)NPO与Hi-ONE光引擎:由于昇腾960超节点采用全光NPO架构,这是业界首个量产的NPO产品,用约5,500个Hi-ONE光引擎替代了传统的4.8万颗可插拔光模块,功耗降低超550千瓦,系统无故障运行时间提升一倍,系统可用度达到99.8%,加速前沿模型的训练与推理创新。
(3)液冷和电源端:包括冷板、CDU、泵阀、UPS、PDU、储能等,核心难点是防漏液、长期可靠运行和高功率供电。
(1)超节点整机&服务器集成:华为及昇腾硬件合作伙伴(如硬件OEM/ODM厂商)负责超节点机柜的正交背板焊接、高密印制电路板(高层数高频高速PCB/CCL覆铜板)及整机柜集成。
(2)存储系统整机:华为基于灵衢打造配套的AI记忆存储OceanStor M900,面向Agent推理系统,支持“一跳直连”的华为L3.5层PB级KV Cache缓存管理。
(3)通算超节点协同:基于灵衢全光组网的鲲鹏超节点服务器(最大支持4096节点/256TB统一内存池)与昇腾超节点的硬件级混合编排。
(4)3D数据中心:以三维立体架构,释放更大的算力潜能,将供冷、IT、供电和备电垂直分层,实现高密度部署、快速交付和更方便的设备升级。重新定义数据中心的能力边界,为智能时代构建坚实的算力底座。
(1)算力运营与云服务商:
华为公有云(昇腾AI云服务)、地方政府主导的区域级公共智算中心(如芜湖智算集群等)、第三方IDC运营商。
(2)大模型厂商(十万亿参数标配):
研发10T(十万亿)级以上SOTA大模型的头部互联网企业、AI独角兽及科研院所。昇腾960超节点的高MFU(模型浮点算力利用率)将显著缩短训练周期。
(3)千行百业垂直应用:
尤其在金融风控、自主驾驶等端云协同的场景;另外,生物医药(蛋白质结构预测)、气象预测、工业制造与智慧能源管理等行业应用。
华为这次的全连接大会上,推出了全球首个搭载NPO近封装光学的昇腾960超节点:以昇腾960芯片、Hi‑ONE自研NPO光引擎,搭配3D数据中心正交液冷架构。践行以系统弥补单点、以逻辑架构弥补物理极限,惊艳了全世界。
4096颗NPU在物理上多机柜分散部署,依托灵衢统一内存总线,实现全局统一寻址,逻辑融合为一台超级算力整机。通过系统架构创新构建竞争力,打造中国坚实算力新底座。
NPO是介于传统可插拔光模块与CPO之间,兼顾高带宽、低时延,同时保留可维护性,避开CPO先进封装与良率难题。
华为这套方案以5500个Hi‑ONE替代4800支传统800G光模块,采用近铜远光的互连,大幅削减器件数量、降低整机功耗与故障点,显著压低集群全生命周期TCO。并且还是业界首个量产的NPO产品。
昇腾960超节点采用领先的正交架构和全液冷设计,预计2027年逐步交付,有望重塑智算中心建设范式。同时也将推动NPO国际标准立项,抢占下一代算力互联话语权,带动国内光芯片、FAU、高速PCB、液冷全产业链升级。
放眼未来,十万亿参数大模型训练,瓶颈早已从单芯片算力转向大规模互联。然而,规模化落地仍需验证良率、生态适配与工程运维。
长远看,这代表国产算力跳出单芯片参数竞赛,从硬件采购者转向架构定义者,为下一代3D堆叠数据中心开辟独立可行的技术路线。
摩尔定律渐慢,τ定律正酣。
世界AI的版图上,不再是英伟达一家独大。昇腾的崛起,点燃了中国AI的主权火种,必将重构全球算力的新秩序!

 VIP复盘网
