

“硅基黑土地”的完整图景。
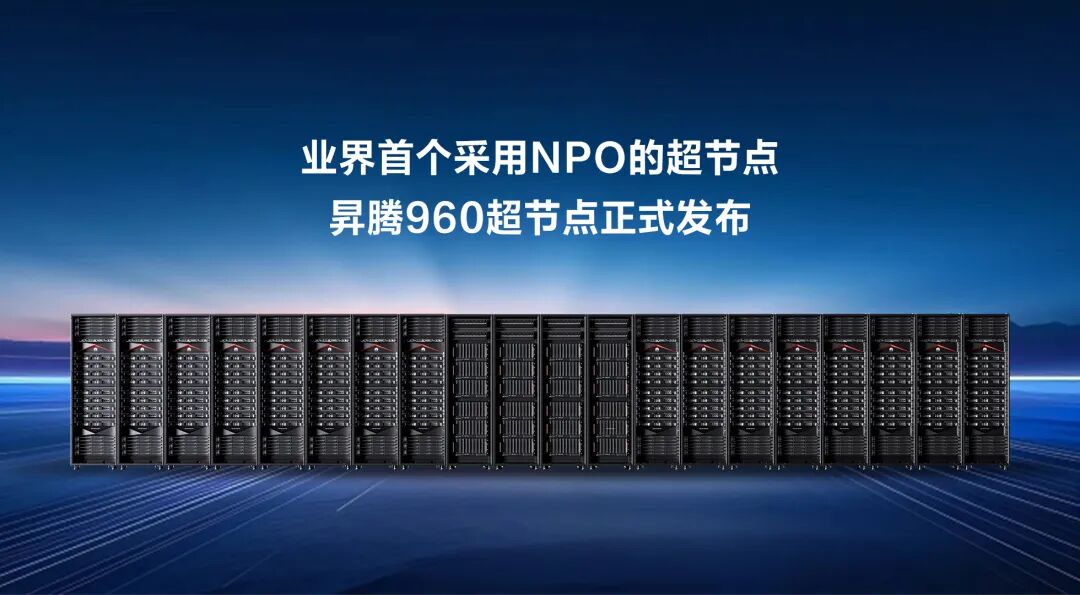
2026年9月17日,上海世博中心。华为全联接大会2026主舞台的聚光灯下,华为副董事长、轮值董事长汪涛发表题为“智启新未来,打造智能世界的硅基黑土地”的主旨演讲,正式发布全球首个采用NPO技术的超节点昇腾960超节点。
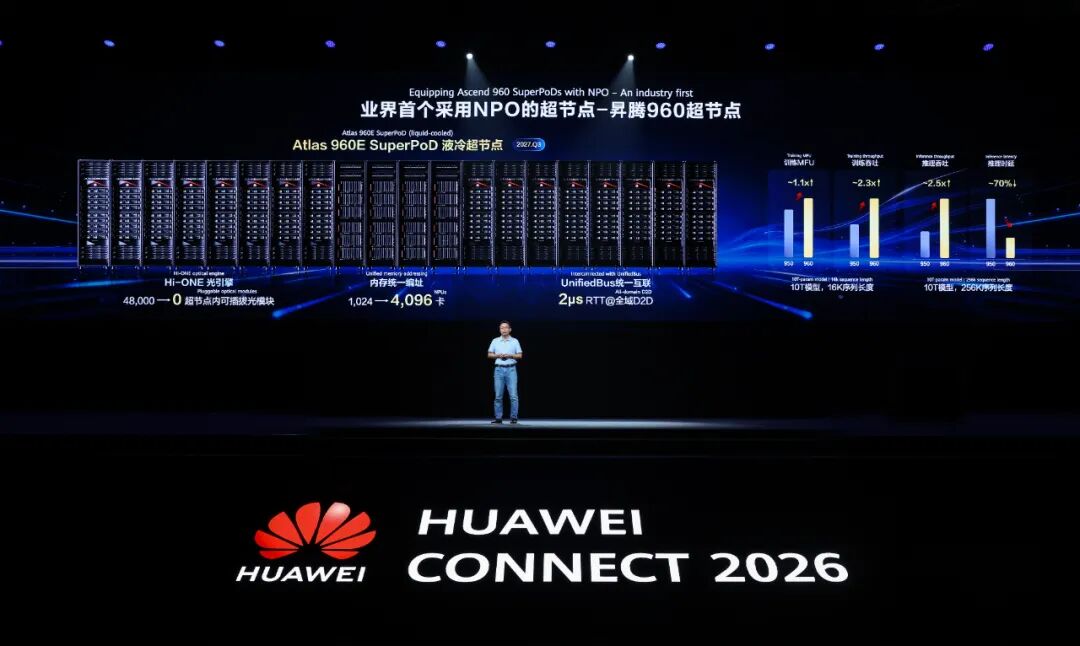
一组数字足以定格这一刻的分量,单个超节点支持4096卡规模,最大可提供8E FP8算力、16E FP4算力,高达1PB的HBM容量;用5500个自研NPO光引擎Hi-ONE,替代了原本需要的4.8万个800G光模块,功耗降低超550千瓦,系统无故障运行时间提升一倍,可用度达到99.8%。多个昇腾960超节点通过灵衢网络或RoCE连接,二层CLOS四平面组网最大可达51.2万卡,结合多轨道拓扑技术可支持100万卡超大规模集群。
汪涛指出,华为AI战略的核心是算力,坚持硬件变现,聚焦做好AI基础设施,打造智能世界的硅基黑土地。我们坚持围绕‘超节点+集群’,通过系统架构创新构建竞争力,打造中国坚实算力底座,构建开源开放的算力生态,为世界构建新的选择。
超节点+NPO,这两个技术关键词的叠加,正在重新定义AI算力的效率公式。
超节点为什么是必由之路
要理解昇腾960超节点为什么重要,先要直面一个行业现实,你花费百亿级资金搭建的10万卡集群,可能有超过七成的算力并没有在真正计算。
汪涛在HC2026期间的圆桌专访中表示,现在MFU,一个10万卡的集群业界往往是连30%不到,意味着70%是处于故障和故障修复状态。
MFU,这个此前只在专业圈子里讨论的指标,正在成为决定大模型竞赛胜负的核心变量。一个百分点对应三天训练时间,在大模型以周为单位迭代的当下,三天意味着一个版本的领先,意味着产品上线的先后,意味着竞争格局的改写。
算力到底去哪儿了?答案是通信。AI变革的速度超过了历史上任何一次技术革命:今天大模型参数已经快速迈向10万亿,到2030年将达到100万亿以上;智能体已经可以按小时级连续工作,到2030年将以月为单位执行任务;中国每日推理Token已增长到每日500万亿左右,到2030年将达到百万万亿级。规模的指数级扩张,并没有带来效率的同步提升。
今天主流的MoE模型,训练过程中数万颗芯片需要数百万亿次通信来对齐每一层、每一个过程的中间结果。高昂通信代价的背后,源于沿用了几十年的服务器架构。
在传统计算架构中,服务器内通信是百纳秒级,服务器间通信却跳到了几十微秒级。当模型只有百亿参数、集群只有几千卡时,这个跳变可以容忍;但当模型走向十万亿参数、集群走向十万卡规模,这个数量级的差距就变成了无法忽视的效率黑洞。
超节点就是为填平这道通信鸿沟而生。2026年世界人工智能大会期间,鹏城实验室和全球计算联盟(GCC)联合38家单位发布《超节点定义与实践白皮书》,明确定义,超节点是一种在物理上由多个计算节点通过高效互联协议紧密连接,具备跨物理节点统一内存编址能力,逻辑上具备“一台计算机”特征的计算系统。超节点由此成为产、学、研在AI基础设施领域的共识。
而本次发布的昇腾960超节点,将单超节点规模从1024卡直接推高到4096卡,更好地匹配十万亿级大模型的训练和推理需求。
汪涛表示,我们走不同的创新路径,利用全新的系统创新架构。我们采用了“超节点+集群”,以多个规模算力构成高速的系统,来满足超大规模大模型的训练和推理要求,我们找到新的创新架构来满足在中国大模型训练和推理的需求。
光进铜退的“最后几厘米”:
NPO为什么是胜负手
当前大规模AI集群内部主要依赖铜缆进行电互联。在SerDes速率达到224G或以上时,铜缆的各类损耗让信号传输质量急剧下降;更棘手的是工程问题——数千根铜缆捆到一起,安装十分困难、维护效率低下、散热压力巨大。这是物理层面的硬约束,不是靠工程优化就能绕过去的。
出路只有一条,把光引到计算芯片的最边上。这就是NPO,近封装光学(Near-Packaged Optics),作为与计算芯片近封装的光引擎,可在计算芯片的边缘几厘米处实现电转光,从而突破铜缆传输距离与带宽的物理极限,显著降低互联功耗与延迟,并解决高密度集群下的布线与散热难题。
几厘米,看起来很短,但这“最后几厘米”恰恰是传统光模块和铜缆都无法有效覆盖的盲区。传统可插拔光模块通常位于服务器面板或交换机面板,距离计算芯片还有几十厘米甚至更远的电信号传输距离;铜缆虽然可以近距离连接,但带宽和距离都有物理上限。NPO把光引擎直接放到计算芯片旁边,让电信号只走几厘米就转换成光信号,从根本上解决了这个问题。
一个NPO所谓的7.2T,是把36个200G的Lane集成在一个模块里。一个小的Hi-ONE模块代替9个800G光模块。这种集成度的提升,不仅仅是体积的缩小,更是可靠性、功耗和可维护性的本质飞跃。
但知道NPO重要是一回事,能把NPO做出来、量产出货、规模应用,是另一回事。在NPO这个赛道,实验室里的原型并不少见,但真正能量产、能交付、能在超节点中规模应用的,华为是第一个。
华为研发的新一代NPO形态光互联产品,Hi-ONE,基于华为自主创新技术,通过光、机、电、磁、热等要素的均衡设计,实现了单引擎7.2T的传输容量。汪涛在圆桌专访中总结了Hi-ONE的三个“第一”。即业界首个量产的NPO产品,是目前行业最大传输能力的NPO产品,也是唯一实现内置光源的NPO产品。
三个“第一”叠加在一起,带来的系统级收益是惊人的,昇腾960超节点通过Hi-ONE光引擎,在超节点内部减少4.8万个800G光模块,降低了550多千瓦功耗——这相当于一个中小型数据中心的制冷负载——系统无故障运行时间提升一倍,系统可用度达到99.8%。
更值得关注的是,华为并没有把NPO做成封闭的私有技术。华为在全球光互联标准组织OIF提出了NPO标准立项的建议,得到了众多行业伙伴的积极响应。这意味着华为不仅自己在做NPO,还在推动NPO成为行业标准,构建产业生态。从技术突破到规模量产,再到标准推动,Hi-ONE走的是一条“技术—产品—生态”的完整路径。
系统工程与开放生态
构筑“硅基黑土地”完整图景
NPO和超节点固然关键,但它们只是华为AI基础设施战略的表层。真正让竞争对手难以追赶的,是华为把计算、通信、光、存储、软件全部打通的系统工程能力,以及在这个能力之上构建的开放生态。
汪涛在圆桌专访中说了一段可以视为华为AI战略“方法论”的话,要提供有竞争力的训练和推理系统,只做好一个芯片不够,只做一个整机和服务器也是不够的,它最后需要的是复杂的多学科的系统工程的能力,给客户交付一个高可用度的计算系统,这才是有价值的。
在AI算力的竞争中,单点技术的领先很容易被追平,但系统工程能力的护城河,是需要长期、多领域、大规模投入才能建立的。
华为的系统工程能力,首先体现在“灵衢”这个统一互联架构上。基于灵衢UnifiedBus,华为打造了11颗关键芯片套片,全面覆盖计算、互联、存储、管理等关键能力。灵衢UnifiedBus把多种互联协议统一为灵衢协议,大幅减少协议转换开销,实现昇腾超节点、鲲鹏超节点、KV缓存集群等子系统的平等互联。这种“一套协议连所有”的架构思路,和传统数据中心中计算网络、存储网络、管理网络各自为政的格局形成了鲜明对比。
在核心芯片层面,华为宣布昇腾960芯片研发进度超出预期:960DT比原计划提前三个季度,2027年第一季度就绪;960PR比原计划提前一个季度,2027年第三季度就绪。未来,昇腾系列芯片将持续坚持一年一代的演进节奏,2028和2029年将陆续推出昇腾970、980芯片,依托τ定律的创新方向,实现算力规格继续翻倍,访存带宽、访存容量、互联带宽等也将大幅提升。芯片不再是孤立的芯片,而是整个超节点系统中的一个组件,其性能提升会通过灵衢互联、Hi-ONE光引擎、全液冷设计、系统级调度等多个环节,转化为整个系统的效率提升。
在通算层面,华为将超节点架构引入通算系统,全新升级鲲鹏超节点。基于灵衢全光组网,鲲鹏超节点最大支持4096节点,形成高达256TB的统一内存池,可显著加速Agent性能。在Agent沙箱场景,十万级别沙箱启动相比传统服务器方案提升30倍,且沙箱密度还可以再提升25%;在Agent向量检索场景,在百亿千维的复杂向量检索场景下,实现检索效率比传统服务器性能倍增。
在存储层面,华为推出了基于灵衢UnifiedBus总线、支持“一跳直连”的L3.5层PB级KV缓存——OceanStor M900集群。Agent与长序列需要多层次KV Cache架构,M900采用混合介质加优化Retention算法,可将SSD读写寿命提升16倍,从底层保障KV命中和长稳可靠。
把昇腾超节点、鲲鹏超节点、OceanStor M900通过灵衢UnifiedBus连接在一起,就构成了华为的Agentic超节点集群。通过二层CLOS四平面组网,最大集群规模可达到51.2万卡;再结合多轨道拓扑技术,最大可支持100万卡昇腾超节点集群。百万卡不是把100万张卡简单堆在一起,它需要高效的互联、可靠的运行、智能的调度、统一的内存池化、多层次的KV缓存——这是一个极其复杂的系统工程,不是任何单点厂商能够完成的。
硬件之上,是生态。
汪涛明确表示:“构建开源开放的算力生态是华为公司的核心战略。”经过八年的努力,昇腾生态跨过了从“可用”到“易用”的拐点。CANN作为昇腾生态的根基,已进入常态化的开源社区运作,软件代码全部开源至GitCode,外部开发者首次超越内部开发者占比61%,社区月活突破5200名,是中国最活跃的AI开源社区;基于昇腾+CANN的原生训练模型已超过40个,也是国内唯一支持预训练的技术路线。
华为推动通信网络从“服务于人的连接”向“围绕用算”发生根本性变革,基于5G-A/6G、万兆光网及多级协同低时延承载网,打造从中心到边缘到端的智能联接体系。从超大规模训练集群到高效推理集群,到边缘计算,到端侧AI,再到把所有算力连接起来的智能网络,这才是“硅基黑土地”的完整图景。

 VIP复盘网
