

9月16日,沐曦股份与魔形智能宣布达成生态合作。双方将围绕国产算力集群探索Token(词元)工厂建设的全新范式,并加速超节点算力集群产品的应用落地。目前,基于沐曦股份国产GPGPU产品部署的万卡智算集群已正式投入魔形智能“Token超级工厂”的生产环境,成为支撑大规模Token生产的国产算力底座。
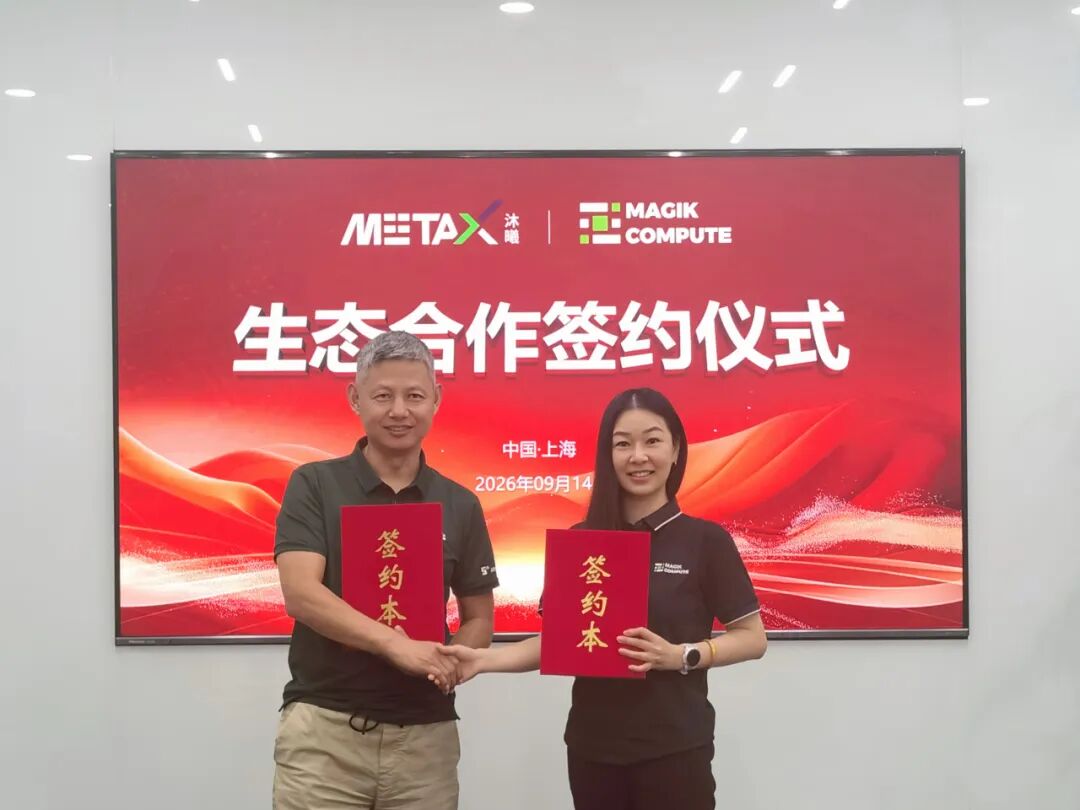
沐曦股份联合创始人、CTO杨建(左)
与魔形智能创始人、CTO金琛
依托沐曦股份GPGPU产品的优异性能表现与魔形智能自研的高性能AI推理引擎,“Token超级工厂”在大规模、全国产算力集群的条件下,实现了行业领先的吞吐能力、时延水平以及长周期运行可靠性。
沐曦股份致力于自主研发全栈高性能GPU芯片及计算平台,目前已推出曦云C系列、曦思N系列、曦彩G系列、曦索X系列GPU产品,覆盖人工智能训练与推理、图形渲染、科学智能等领域。所有产品均基于沐曦自研核心 GPU IP、架构与指令集打造,并配套公司自研 MXMACA 软件栈,真正实现“软硬协同”,以满足行业“高能效”和“高通用性”的算力需求。
得益于沐曦股份成熟的MXMACA软件栈与魔形智能突出的部署优化能力,双方合作的首批大规模算力集群仅用1-2天时间即完成了从集群就绪到业务模型上线的全过程。集群投产后,也可迅速实现新模型的引入与适配,支持多种主流开源模型与多模态任务接入,新增业务无需重复经历长周期的底层适配。
面向下一阶段,双方将在超节点算力集群方向继续深化合作、协同研发,推动超节点算力集群产品的应用落地与商业化,围绕国产算力进一步提升“Token超级工厂”的高质量Token生产能力,并吸引包括计算、互联、存储、液冷等超节点关键子系统层面的合作伙伴共建超节点算力生态,以生态发展满足AI产业迭代中迅速扩大的算力需求。
沐曦股份联合创始人、CTO杨建表示:“算力的价值,最终要在真实业务的长期运行中被检验。过去评价一颗芯片,看的是峰值算力;今天评价一个算力底座,看的是它在生产环境中每天能稳定交付多少高质量Token、以怎样的成本和能效交付。沐曦坚持全栈自研与生态兼容并重,很高兴与魔形智能这样在推理系统和工程优化上有深厚积累的伙伴深度协同,我们也期待以下一代超节点产品为载体,与合作伙伴共同探索Token工厂场景下软硬件协同的新范式。”
魔形智能创始人、CTO金琛表示:“全球AI产业的竞争格局,正从单纯的模型竞赛转向全产业链能力的比拼。一个国家AI产业的发展水平最终体现为高质量Token生产能力。我们希望能够与沐曦股份这样的国产算力厂商共同努力,通过软硬件协同优化,加强国产算力在生产级业务中的竞争力,并探索下一代超节点硬件产品在Token工厂场景中的更多可能,寻找全新技术范式。”

 VIP复盘网
