

但进入 Agentic AI 时代,这套评价体系依然悄然开始发生变化。问题的根源在于——软件与硬件的节奏已经彻底错位。
端侧AI,CPU决定下限
为了更好的训练模型,过去的云端主要追求“更大、更统一”的算力。但在伴随更多AI应用落地,AI加速走向推理之后,变化的不是算力规模,而是算力本身。因为现在我们见到的千行百业中每一种引入AI的终端都对AI芯片的延迟、功耗、带宽、成本和实时性的要求却截然不同。
换而言之,端侧不再存在一套能够覆盖所有场景的标准答案,而是形成了大量差异化、碎片化的应用需求。
与此同时,模型生态同样还在快速演进。从早期端侧主要运行 CNN,用于人脸识别、目标检测等视觉任务;到语音交互催生了 ASR、TTS 等模型;再之后,大语言模型、多模态模型开始崛起;机器人又进一步引入 VLA模型起。在模型结构不断变化的过程中,底层算子持续增加,不同模型对于计算精度、存储访问和数据流组织的要求也越来越复杂。
于是,端侧 AI 芯片面临的核心矛盾就开始从“算力够不够”变成了“通用性与能效如何兼得”。
纵观市场上现行的加速器,主要有两种:一种是像 GPU 一样构建完全可编程的统一计算架构。它拥有最强的模型兼容能力,几乎可以适配不断出现的新模型、新算子,但代价是面积、功耗和能效并不适合大量终端设备;另一种则是针对固定模型设计专用加速器,将常用算子全部固化为硬件,能够获得极高的性能功耗比,却容易随着模型迭代迅速失去适配能力,生命周期受到限制。
对于当前的端侧AI应用来说,上述任何一种方案都不是最优选。这也意味着,端侧AI解决方案不再是简单地二选一,而是需要找到一条清晰的边界:哪些能力应该固化为硬件,以获得最高能效;哪些能力应该保留可编程性,以适应未来模型持续演进。
达摩院玄铁团队也认为,端侧 AI 芯片需要的不只是更大的 NPU,而是一套更高效的异构计算架构。正是看到了这一点,他们提出了一种面向端侧 AI 的异构计算思路——以可编程、可扩展的 CPU 承接推理中灵活多变的任务,以专用 AI 加速单元负责高吞吐计算,通过统一调度释放整个平台的算力效率。
“NPU 决定算力的峰值,CPU 决定算力能不能真正发挥出来。”玄铁专家总结说。他们进一步指出,模型切换、混合负载、缓存调度、实时响应等影响用户体验的关键环节,本质上都依赖 CPU 的协调能力。
因此,端侧 AI 的真实竞争力,不只是 NPU 拥有多少 TOPS,更在于 CPU 能否高效调度整个异构计算系统,让有限的算力转化为可持续、可落地的 AI 能力。这种转变,让曾长期被视为“幕后角色”的 CPU 重新成为端侧 AI 架构的核心。而以开放、可扩展著称的 RISC-V,也正在这一轮端侧 AI 与具身智能浪潮中迎来新的机遇。
玄铁正围绕 RISC-V 构建从处理器 IP、AI 软件栈到异构计算平台的完整生态,希望为未来数十亿台 AI 终端提供统一而开放的基础架构。
从RISC-V出发,为端侧 NPU 打造可编程底座
为何是RISC-V?这首先固然与这个新型架构在端侧 AI 应用上具备可定制、RVV 向量算力以及低授权成本等优势有关。
RISC-V的开放架构支持针对不同算法与场景灵活扩展,更适应端侧 AI 的碎片化需求;RVV 则让 CPU 能直接参与 AI 推理,并通过软件快速适配不断演进的模型;而低授权成本与开放生态,则为 AI 眼镜、机器人、玩具等成本敏感型终端提供了更高的开发灵活性和规模化落地能力。
除此以外,玄铁表示,公司深耕RISC-V多年,助力客户出货超六十亿RISC-V芯片,让团队对RISC-V在端侧AI的未来充满信心。
针对端侧AI的需求,玄铁团队也打造了一个从硬件到软件全链路解决方案,用三层能力,赋能端侧AI。其中,底层由兼容 RVV 的向量算力承担灵活推理,中间通过 CPU、NPU 与向量单元 的异构调度实现算力协同,上层针对主流 AI 算法进行深度优化,加速模型落地。同时,统一工具链覆盖从高性能处理器到 MCU 的完整 IP 谱系,帮助客户缩短开发周期。
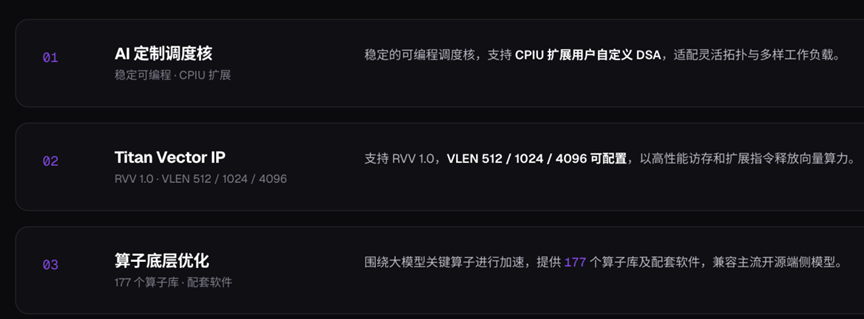
具体而言,玄铁将端侧 AI IP 拆分为三大能力:调度核、Titan 向量计算 IP 和 RVV 算子库。其中,调度核负责取指、多发射及异构资源调度;新增的 Titan Vector IP 将 Softmax、TopK 等大模型中的非矩阵算子从 NPU 中独立出来,以向量单元完成计算,从而降低 TPU/Tensor 的设计复杂度,并支持 512 位至 4096 位可扩展向量算力;同时,玄铁还提供完整的 RVV 算子库,将高频算子硬件化、长尾算子进行汇编优化,帮助客户更快适配不同 AI 模型并缩短开发周期。
玄铁强调,公司此次发布的端侧 AI IP,并非单纯提供一颗 CPU,而是提供两种可落地的异构计算方案:一种是目前已被多数 NPU 厂商采用的纯调度核方案,由 CPU 负责取指、译码、多发射和异构资源调度,DMA 与 Tensor 计算单元则由 SoC 厂商自行设计;另一种则是在调度核基础上加入 Titan 向量计算扩展,将 Softmax、TopK、指数、三角函数等大模型中的非矩阵算子从 Tensor 中独立出来,由 RVV 向量单元承担计算,在降低 AI 加速器设计复杂度的同时,显著提升端侧大模型效率。
更重要的是,Titan 采用可扩展的 RVV 架构,向量位宽可由 512 位扩展至 4096 位,并配套 177 个深度优化算子、GCC/LLVM 编译工具链及可扩展指令接口,形成从硬件 IP 到软件生态的完整方案。
玄铁公布的实测数据显示,在千问 1.7B 模型的 Prefill 阶段,随着 RVV 位宽提升至 4096 位,Softmax 等热点算子的计算性能提升约 15 倍,首字延迟可由 7.9 秒缩短至 3.5 秒,为端侧大模型带来更快的响应速度,同时也为更小面积、更高良率的 AI 芯片设计提供了新的思路。
在近日举办的Elexcon第23届深圳国际电子展暨嵌入式展期间,玄铁团队带来了两款处理器C920和C908X分享。与此同时,公司还展示了基于公司IP以及上述三层能力打造的端侧AI算力方案,加速终端客户走进AI新时代。
两款CPU,三个典型案例
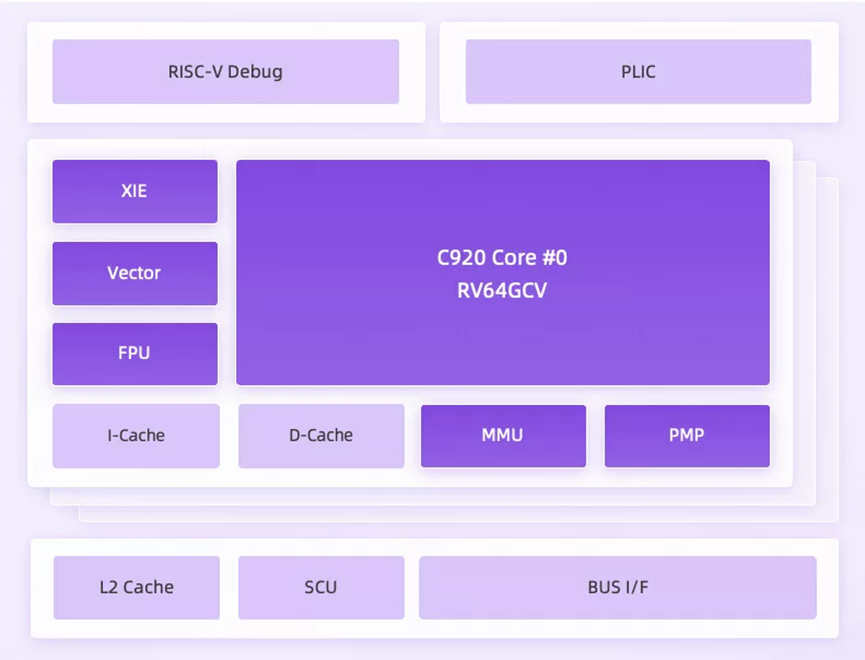
资料显示,为此次推出的端侧AI方案,玄铁准备了两款CPU,分别是玄铁C920和C908X。其中,C920是一款兼容 RISC-V 架构的64位处理器,支持Vector1.0,兼容RVA22 profile,支持多核多 Cluster。采用12级多发乱序流水线,工作频率可达到2.5GHz,标配单精度浮点单元,并可进一步选配高性能乱序矢量运算单元。
该处理器同时具备出色的访存能力,支持高性能数据预取技术。主要应用于消费级应用处理器 、AI机器视觉、边缘计算、高性能控制器等领域。
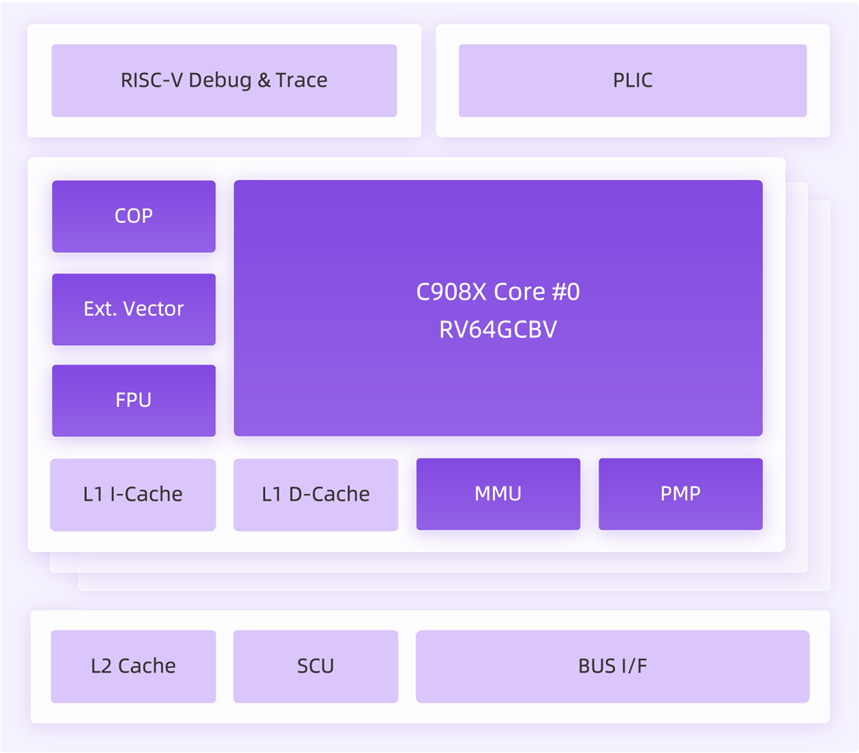
至于玄铁C908X,则是一款兼容RISC-V架构的64位AI处理器,矢量指令基于RVV1.0,支持同构多核。提供超宽矢量指令和预置AI加速指令进行AI运算加速,通过扩展矢量宽度,C908X可提供最大 1TOPS/Core/GHz 算力并支持多种AI 算子库。同时,基于VirtualZone安全技术和GP安全认证,玄铁C908X可支持安全可信执行环境(TEE),适用于AI 加速与推理、边缘 AI 计算等领域。
基于C908X,玄铁AI方案面向边缘及端侧智算场景,助力 AI 部署及大模型部署的加速。该方案配套成熟的软件生态,实测表明,相较于传统架构,该方案在 AI 推理任务中的吞吐量提升高达 300%,能效比提升超过 200%。
基于这次发布的 C920、C908X和过往已经大规模量产的 C906、C907等内核,玄铁合作伙伴已经推出了数十亿颗芯片。如上所述,玄铁这次就带来了三款基于公司内核打造的三款典型端侧 AI 产品:全志 V861、瑞芯微 RK1820和特普斯微的 EA6530 开发板。
其中,基于玄铁双核 64 位 RISC-V 架构的全志 V861是轻量级智能视觉主控。,集成 1 TOPS NPU 与新一代 AI-ISP,让摄像头从“看得清”升级为“看得懂”,并凭借高集成、小封装设计,瞄准 AI 眼镜等轻量端侧视觉市场;
搭载玄铁RISC-V CPU的瑞芯微 RK1820则丁伟伟一颗端侧大模型协处理器,采用外挂式协处理架构,通过高速接口连接主控,集成高性能 NPU 与 3D 堆叠内存,突破端侧带宽瓶颈,可让 7B 大模型实现 100+ Token/s 推理,为 AI 玩具、学习机和工业设备提供低成本智能升级方案;
特普斯微 EA6530则是一个机器人边缘计算平台,搭载 8 核玄铁 C920v2 与 24 TOPS NPU,可在单芯片内完成机器人感知、控制、导航等多项任务,为机器人开发提供开箱即用的算法验证平台。
“这三款产品别对应端侧 AI 的三种主流形态:轻量级智能视觉主控、外挂式大模型协处理器,以及机器人边缘计算平台。三者虽然面向不同场景,却有一个共同点——全部基于 RISC-V 架构,也印证了玄铁已在轻量主控、算力扩展和边缘全能三大方向完成量产落地。”玄铁方面强调。
持续向上突破,从“能用"变成"首选"
在问到当前和未来规划时,玄铁表示,公司正在聚焦于三大处理器 IP 方向,分别是端侧 AI、SSD 主控与具身智能。
其中,端侧 AI 强调 CPU+NPU 异构协同与 RVV 向量算力,提升模型适配效率;SSD 主控面向 PCIe 5.0 存储升级,提供高实时、可扩展的处理器 IP;具身智能则以完整 IP 谱系覆盖机器人从“大脑”到“关节”的分层计算需求。之所以看中这三个方向,是因为这些市场的特性和玄铁团队“算力决定上限,CPU 决定下限”的观点符合。
玄铁判断,未来一到两年最大的产业机会将是 AI 算力从云端走向终端,而 RISC-V 有望成为这一迁移中最受益的架构。与此同时,高性能 RISC-V 也在持续突破,从服务器级 C930 到旗舰 C950,不断拓展 RISC-V 的性能边界。
“RISC-V 的机会已不再是‘替代’,而是在端侧 AI 和机器人等新市场成为‘首选’。”玄铁强调。

 VIP复盘网
