

世界模型用在自动驾驶领域需要增加一个Action Expert(实际就是解码阶段),也就是WAM。
三种世界模型对比
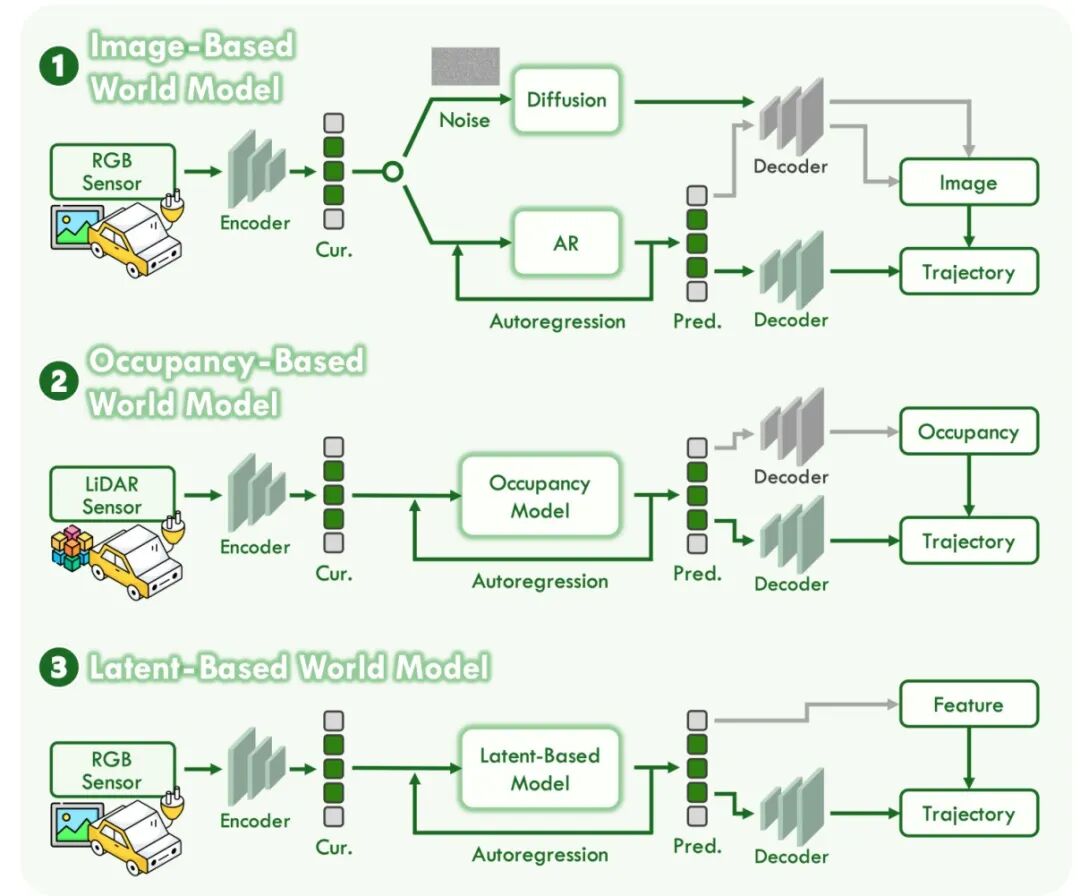
图片来源:论文《Vision-Language-Action Models for Autonomous Driving: Past, Present, and Future》
世界模型再分为基于像素的、基于占用网络的和基于潜空间的三大类。动作专家主要也分三大类,一是基于扩散,二是基于flow matching,三是基于MLP的。
与常见的AI应用不同,自动驾驶和机器人在大模型推理时每次只有一个样本量,只有一个请求,也就是说其批处理规模batch size=1,这就意味着GPU/NPU的利用率很低,因为GPU/NPU是并行处理结构,batch size越高,吞吐量就越高,利用率就越高。batch size=1意味着几乎变成了串行结构,GPU/NPU的并行处理能力完全没法显示。
英伟达开源自动驾驶模型Alpamayo R1的推理Runtime分析
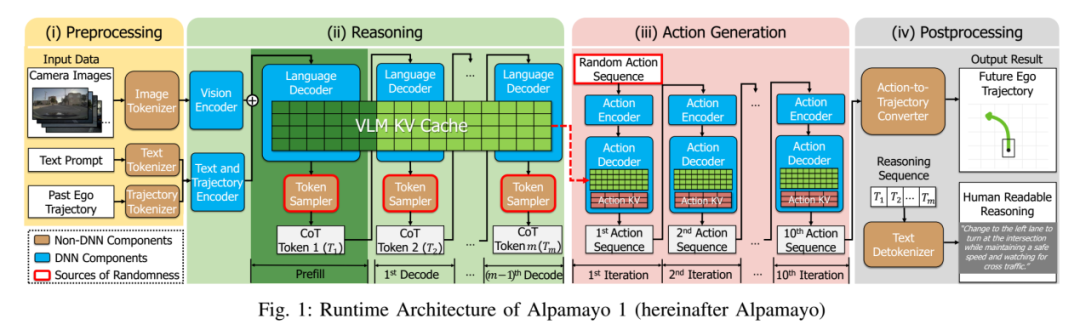
图片来源:论文《Latency Analysis and Optimization of Alpamayo 1 via Effcient Trajectory Generation》
无论是VLA还是WAM,其推理runtime基本都是上面的四个部分,首先是输入数据的预处理即编码,这部分很少有人提及,它主要包括图像tokenizer分词化,输入文本提示词的分词化,还有自车轨迹的分词化,这里的text prompt实际就是导航指令,从A点到B点的语音输入再转换为文本。这些分词化实际是矢量嵌入,它不是深度神经网络,一般都由CPU而非NPU负责。第二部分是推理。第三部分是动作生成也就是动作专家。第四部分是后处理,将动作token转换为waypiont,同时为了让乘客理解自动驾驶,将动作token转换文字或语音提示车辆的下一个动作。第四部分也是由CPU完成,而非NPU或GPU。
绝大部分论文都不考虑实际落地,因为论文就是前瞻性研究,但也有例外。我找了几篇对世界模型自动驾驶推理延迟分析的论文,第一篇是英伟达联合UT奥斯汀和斯坦福大学的《Latent Chain-of-Thought World Modeling for End-to-End Autonomous Driving》,11位作者中10位都来自英伟达。论文提出了Latent-CoT-Drive (LCDrive) 模型,与依赖文本思维链不同,LCDrive 通过基于学习的潜世界模型 (LWM) 的向量空间监督思维链tokens进行推理,该方法通过在动作对齐的潜空间中表示思维链推理和决策,从而统一两者。该模型不使用自然语言,而是通过交替使用以下两种tokens进行推理:(1)动作提议tokens,这些tokens使用与模型输出动作相同的词汇;(2)世界模型tokens,这些tokens基于学习的潜世界模型,并表达这些动作的未来结果。通过监督模型的动作提议和世界模型tokens,并基于场景的真实未来演变轨迹,对潜思维链进行冷启动训练。
Latent-CoT-Drive (LCDrive) 模型架构
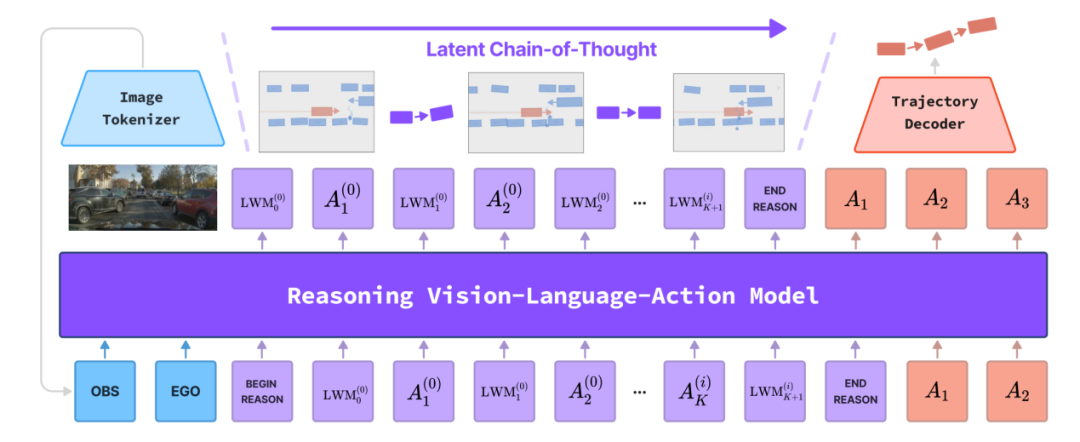
图片来源:论文《Latent Chain-of-Thought World Modeling for End-to-End Autonomous Driving》
LCDrive模型架构表明实际就是用VLA增强世界模型。英伟达选择了Qwen-0.5B的VLM,参数最少,只有5亿,选择了DINOv2做视频的分词化tokenizer。输入摄像头只有两个,一个宽FOV 120度,一个30度,分辨率为320*512。
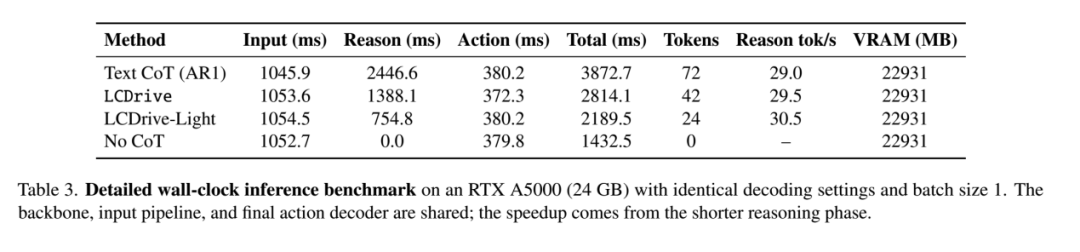
图片来源:论文《Latent Chain-of-Thought World Modeling for End-to-End Autonomous Driving》
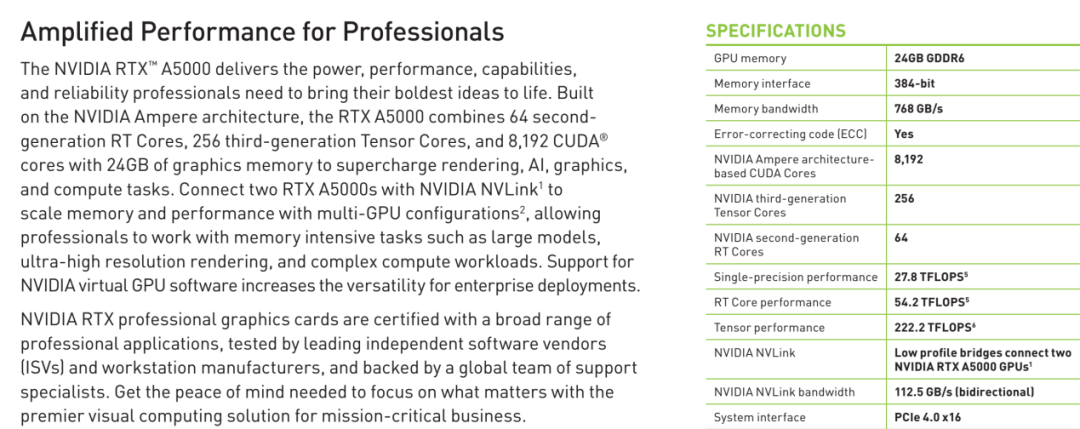
AR1即文本型思维链,是对比基线,英伟达使用RTX A5000专业显卡推理,价格大概是2.1-2.2万人民币。这里的wall-clock就是墙钟,Wall time(也称为clock time 或real time)和Real time 意义相同,都是指程序从开始执行到结束所花费的时间,包括了CPU/GPU 时间和与CPU /GPU时间无关的时间。可以看出轻量级的LCDrive都需要2.2秒,这个显然无法落地,自动驾驶最低下限是10Hz,也就是200毫秒。如果是高速场景,最低下限是20Hz,也就是100毫秒。这里英伟达特别点出batch size为1,这也是为何推理速度慢的主要原因。
NVIDIA RTXTM A5000
图片来源:NVIDIA
RTX A5000专业显卡性能算力不高,只有222TOPS,但是其存储带宽很高,有768GB/s,是英伟达Thor-U存储带宽的2.8倍。比英伟达Orin-X实际要高,英伟达Orin-X的AI算力分三部分,一是DLA,二是CUDA核心,三是Tensor核心。DLA是一个外设,是Devices,不可编程,它只能做卷积运算。而LLM/VLM/VLA时代,从头到尾都是transformer架构,根本没有DLA用武之地,LLM/VLM/VLA时代英伟达Orin-X的稀疏算力值只有167TOPS。
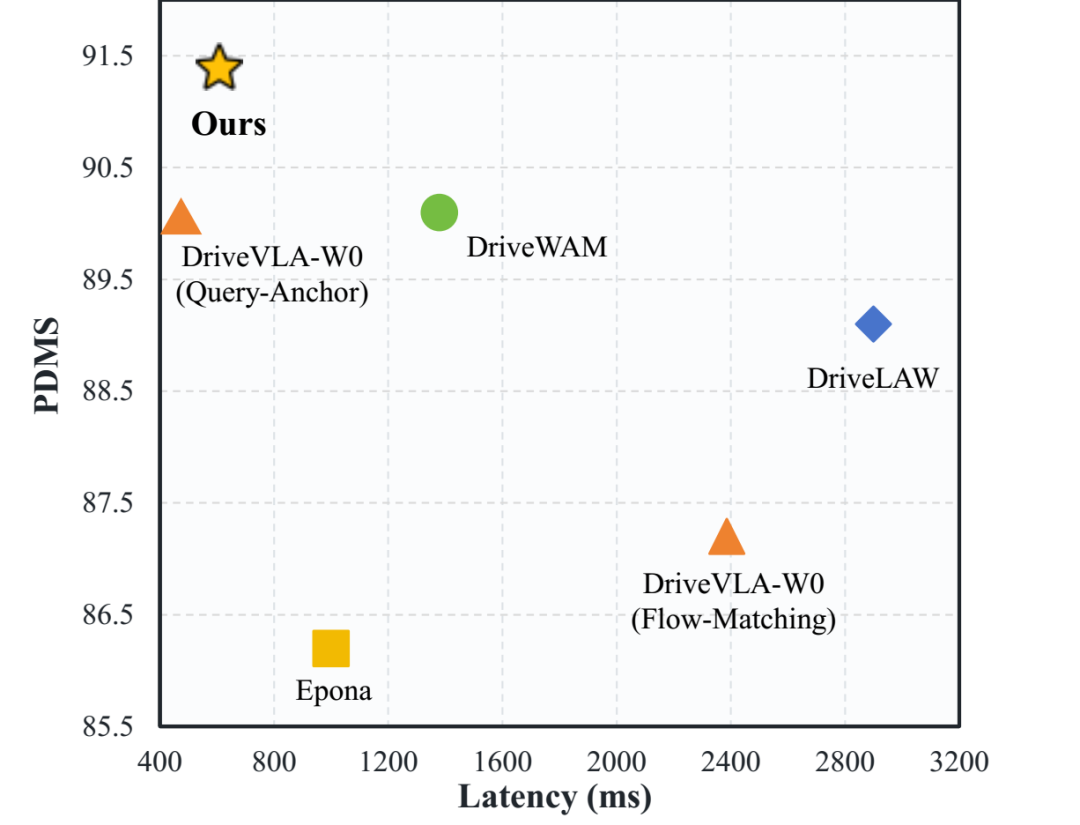
第二篇论文是华中科技大学和东风汽车研究中心的《SimWAM: A Simple World Action Model for End-to-End Autonomous Driving》。
图片来源:论文《SimWAM: A Simple World Action Model for End-to-End Autonomous Driving》
上图中的“Ours”即SimWAM,这里使用的是英伟达的单张A100显卡,A100自2019年推出,直到今天还是卖得很好,并且估计再热卖5年不成问题。目前的价格大约是8-10万人民币。纵轴的PDMS可以简单理解为自动驾驶性能得分,SimWAM最好的成绩同时延迟最低,但即便是最低延迟也在400毫秒之上,达不到市区NOA的10Hz下限。
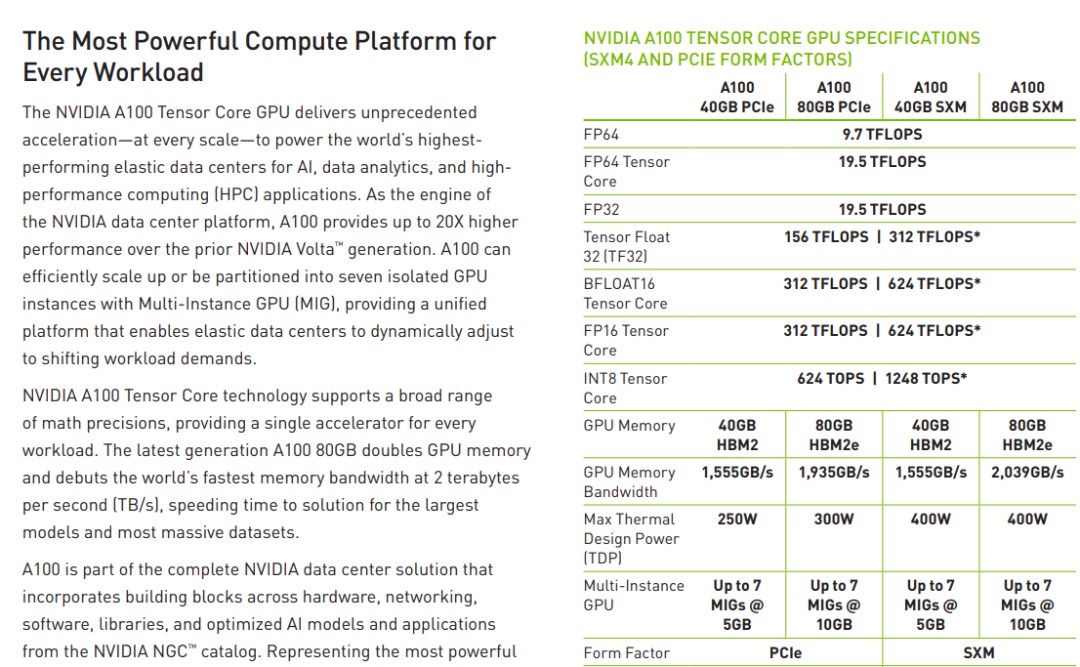
NVIDIA A100 Tensor Core GPU
图片来源:NVIDIA
英伟达A100的算力就强很多,INT8稀疏模式下是1248TOPS,存储带宽也非常高。
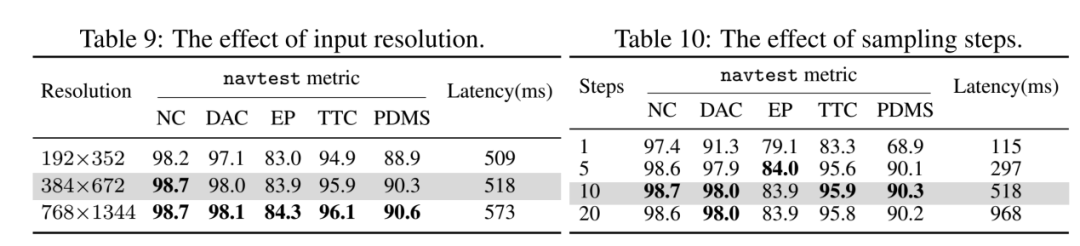
输入分辨率和取样步数对延迟的影响
数据来源:论文《SimWAM: A Simple World Action Model for End-to-End Autonomous Driving》
上图可以看出,分辨率对延迟影响很小,对性能影响也很小,取样步数对延迟影响很大,但取样步数至少要有5步,1步的性能得分太低。5步以上则性能差异不大,当然延迟会大幅度增加。
第三篇论文《Drive-HWM: Hierarchical World Models for Dynamic-Latent Guided Autonomous Driving》,作者主要是北航AI学院和上海交通大学以及极佳科技,还有中国电信研究院。
Drive-HWM提出的快慢两种世界模型
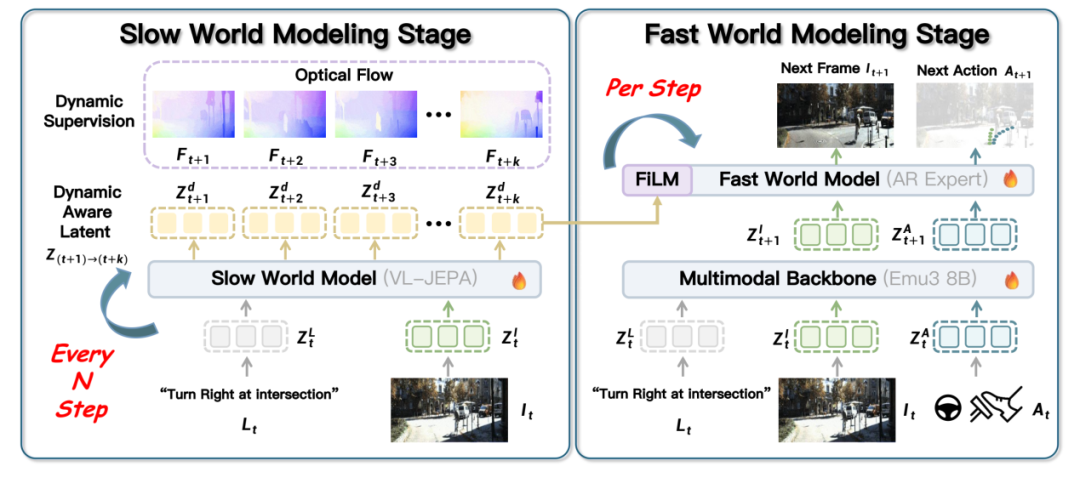
图片来源:论文《Drive-HWM: Hierarchical World Models for Dynamic-Latent Guided Autonomous Driving》
Drive-HWM提出了快慢两种世界模型。慢世界模型使用光流做动态监督,使用META的VL-JEPA做骨干,小鹏和零跑也是使用V-JEPA做骨干,使用多步取样和动态潜空间感知。快世界模型使用北京智源的EMU3,参数是80亿,采用AR自回归动作专家。
Drive-HWM的延迟
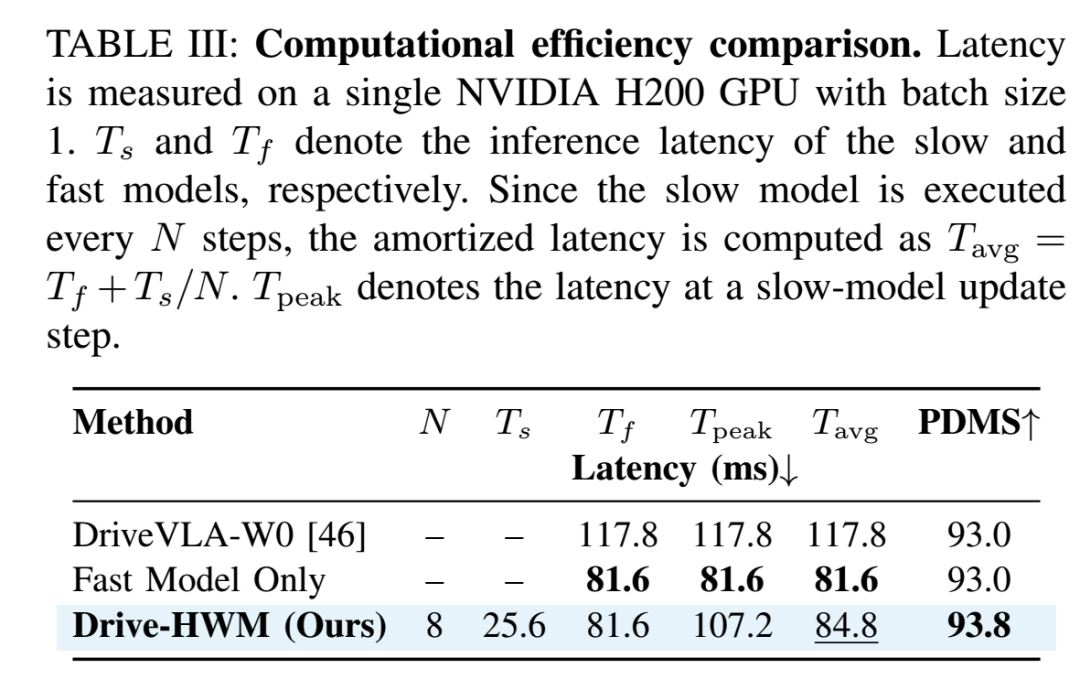
图片来源:论文《Drive-HWM: Hierarchical World Models for Dynamic-Latent Guided Autonomous Driving》
快世界模型使用自回归动作专家,无需多步取样,延迟达到81.6毫秒,DriveVLA-W0则是华为的模型,用世界模型增强VLA,骨干也是80亿参数的EMU3,PDMS得分高达93.8,是目前最强的世界模型。看起来达到10Hz的最低下限,不过这是用英伟达H200取得的。H200价格是22-27万人民币之间。
NVIDIA H200
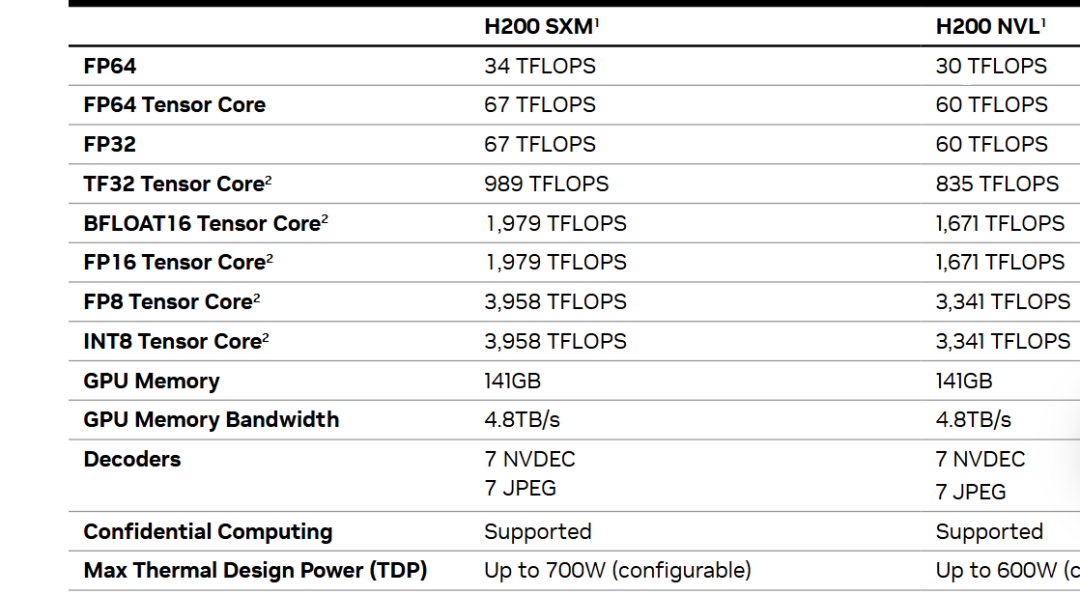
图片来源: NVIDIA
H200的INT8稀疏算力在3300TOPS以上,存储带宽高达4.8TB/s,这个存储带宽是靠高成本的HBM取得的,成本大约1.5万美元,汽车行业显然不可能用HBM。
以上的论文都是用英文写的,受众面很窄,也不是具身智能刷榜的论文能融资,这些论文没有造假的动机,世界模型能不能落地,读者们应该已经非常清楚了。VLA延迟要比世界模型好得多,英伟达Thor-U勉强达到10Hz的下限,实际目前量产的都是传统BEV+占用网络的传统算法,世界模型都是宣传用的。

 VIP复盘网
