

浪潮信息9月11日发布定增预案,拟募资不超90亿元,向不超过35名特定投资者发行股票,已经董事会审议通过。
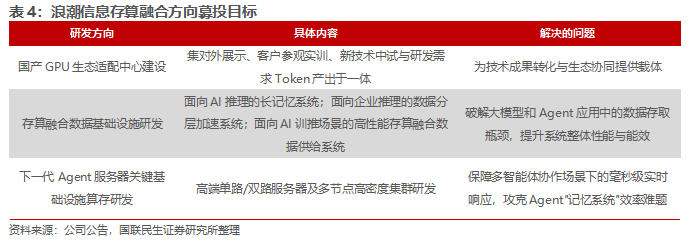
募投重点对应超节点、高端液冷与存算融合等多个方向:1)智能体AI基础设施项目(26亿元):围绕高扩展超节点整机柜、企业级高性能AI服务器开展,拟提升超节点整机柜定制化和规模化生产能力。2)液冷原生项目(14亿元):研发超高密度液冷原生整机柜服务器,满足高功率密度算力集群对散热、供电、结构集成和智能运维的要求,配套推进预制化液冷数据中心快速交付系统等。3)存算融合项目(14亿元):面向“国模+国芯”与前沿技术:建设国产GPU生态适配中心;存算融合数据基础设施研发,覆盖AI推理长记忆系统、AI训推高性能存算融合数据供给系统等。
1.1 超节点:万亿参数大模型的重要算力底座
超节点有望成为万亿参数大模型的核心算力底座。传统"单芯片迭代+服务器横向堆叠"的Scale-Out扩容路径已现双重瓶颈:一是先进制程演进边际收益递减,单芯片性能提升的成本持续抬升;二是分布式集群节点间地址空间独立,跨节点数据的传输需经过多层软件协议栈处理,通信开销随并行规模扩大呈非线性增长,大量算力在数据等待中被闲置,Scaling Law延续在架构层面受到约束。通信时延是决定大规模并行效率的核心变量之一,超节点通过降低跨节点通信的软件开销,实现大规模并行下的近线性性能提升,成为下一代AI算力的核心底座。
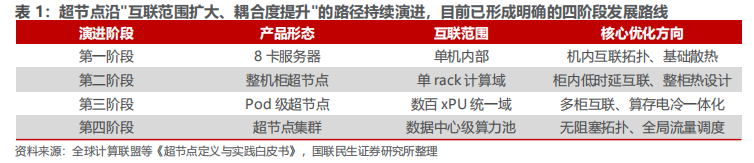
超节点由多个物理计算节点通过专用高速协议连接,具备跨节点统一内存编址能力,逻辑上呈现"单台计算机"特征的紧耦合计算系统,核心是为大模型这类紧耦合并行负载提供垂直扩展的算力承载。与传统Scale-Out分布式集群相比,超节点从架构层面减小了跨节点通信的软件开销,提升了计算效率。
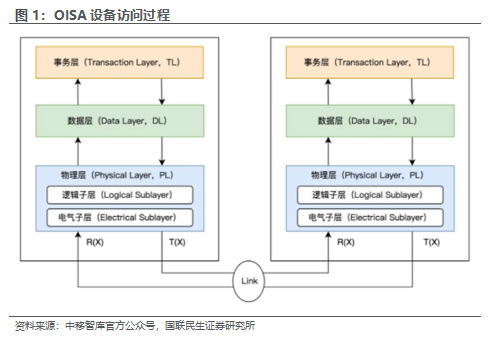
大模型自回归推理存在Prefill(计算密集)与Decode(内存带宽密集)两种资源需求冲突的阶段,超节点可以成为实现P/D分离的重要支撑,因此有望成为下一代AI算力架构的核心形态。在Decode阶段,决定性能的关键因素不再是GPU的峰值算力,而是其在单位时间内能够从显存中读取或写入数据的总量。这一性能直接影响着用户的另一个核心体验指标,即单Token生成延迟,它决定了后续文本生成的流畅度,进而P/D分离架构应运而生,新型的超节点服务器架构实现高效物理分离,凭借强大的内部互连网络,在内部进行P/D任务的划分。同时,在互联协议端,技术的进步可以更有效实现物理带宽能力的释放。以中国移动推动的OISA协议为例,新一代互连技术已经超越了单纯“数据管道”的角色,正在向系统管理中的主动参与者演进。
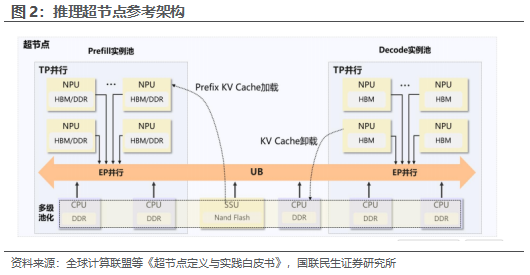
超节点已在大模型预训练、推理、后训练、多模态等流程中验证出架构价值。根据《超节点定义与实践白皮书》,预训练方面,万亿级参数模型的多卡并行部署带来海量集合通信开销,超节点通过NPU间大带宽低时延互联压缩通信开销,在DeepSeek V3训练中未掩盖通信比例降低80%,单NPU裸算力提升2倍条件下系统训练性能实现3倍以上提升。推理方面,万亿参数稀疏化模型需多机大专家并行,每Token推理面临高频跨节点小数据通信与长序列KV Cache缓存双重挑战,超节点通过NPU-to-NPU互联与全局资源池化,能够大幅提升计算效率。
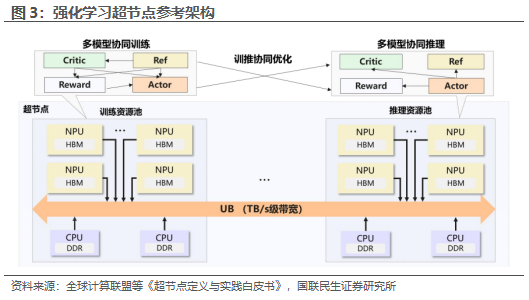
后训练、多模态及Agentic AI场景进一步验证了超节点在大模型全生命周期中的架构延展性。后训练方面,强化学习需同时维护策略、价值、奖励及参考四个模型,参数与梯度同步通信量大,传统集群带宽瓶颈致训练效率下降40%~60%,超节点将模型传输时延从数十秒级降至毫秒级,70B模型RLHF训练中推理时延由数十秒降至秒级。多模态方面,T级参数模型的多任务负载对通信带宽与异构调度提出更高要求,超节点通过逻辑资源池化与内存语义小包超低时延通信提升分布式推理与3DGS重建效率。
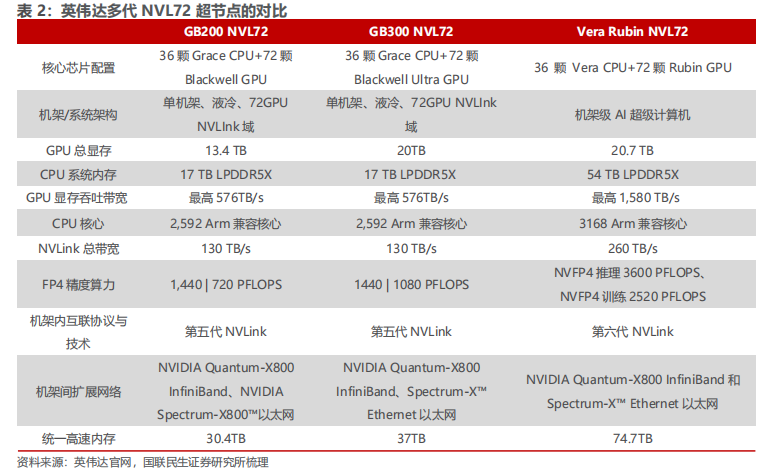
英伟达NVL72系列是全球超节点产品的标杆,从GB200到Vera Rubin,持续迭代并将超节点作为核心产品。
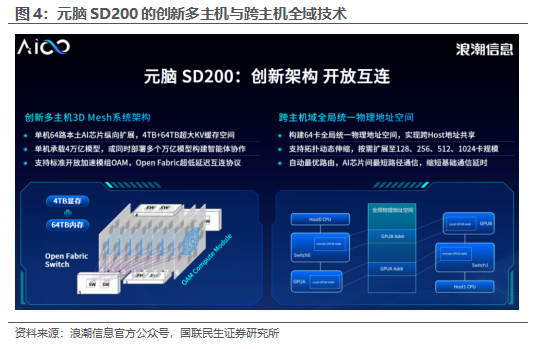
浪潮信息:元脑SD200超节点率先完成Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等主流大模型的高性能优化,在Kimi K2.6万亿参数大模型上实现Token生成时间4.77ms,首Token延迟降低35%,为Agent场景应用的高效运行提供算力支撑。元脑SD200采用多主机低延迟内存语义通信架构,基于开放总线交换技术,在单机内实现64路本土GPU芯片统一寻址与高速互连,依托百纳秒级低延迟链路降低通信与显存访问开销。
1.2 液冷:供需两端共振,市场规模有望快速增长
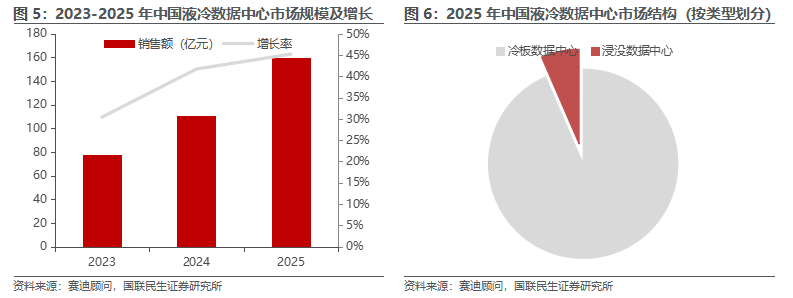
从结构看,液冷市场呈现“冷板主导、机电为主、区域集中”三个特征。技术路线上,冷板式液冷凭借改造成本低、与存量数据中心架构兼容性好的优势占据主导,2025年市场规模149.4亿元、占比93.5%;浸没式液冷规模10.4亿元、占比6.5%,但增速更快,2028年有望增至32.9亿元。产品结构上,CDU、冷板、管路、泵阀等液冷机电设备销售额148.9亿元、市场份额93.2%,冷却液占比6.3%,随着两相浸没式液冷发展,其占比存在小幅提升空间。区域分布上,华东、中南、华北三大区域合计占比接近九成,销售额分别为51.8亿元、50.0亿元和38.7亿元,区域集中度高。
1.3 存算一体:Agent时代存储瓶颈凸显,浪潮信息前瞻布局存算融合
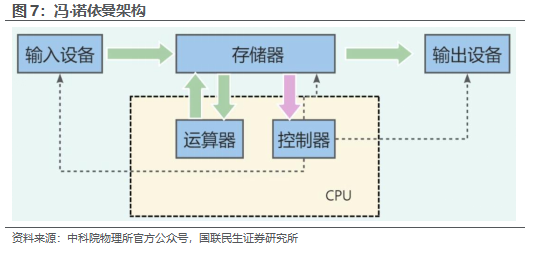
传统冯·诺依曼架构下存储与计算相互分离,AI时代面临“存储墙”与“功耗墙”双重瓶颈。冯·诺依曼架构中,存储与计算是两个相对独立的模块,数据需要在两者之间传输。随着AI崛起、数据计算强度跃升,计算芯片速率持续提升而存储传输速率跟不上,由此产生两堵墙:“存储墙”指存储设备与处理器之间的数据的传输速度远跟不上处理器的计算速度。HBM通过3D封装将存储单元与计算单元封装在一起,缩短两者距离以提高传输速度、降低能耗,在一定程度上缓解了问题,但并未从根本上改变存算分离的现状。存算一体的思路是将存储和计算直接结合,让数据在存储过程中完成计算,减少数据搬运次数,从而提高计算效率并降低功耗。
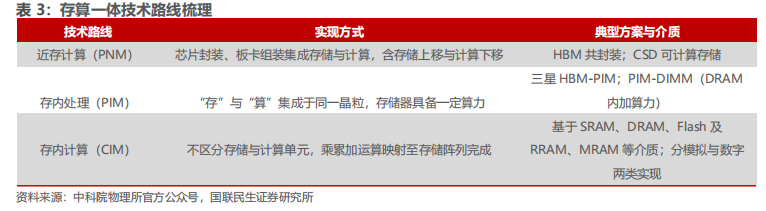
按存储与计算的距离,存算一体可以分为近存计算、存内处理与存内计算三类。近存计算通过芯片封装和板卡组装等方式将存储单元与计算单元集成,以增加访存带宽、减少数据搬移,包括存储上移(HBM共封装)与计算下移(如CSD可计算存储)两种形态;该路线现已广泛应用于AI、大数据、边缘计算、物联网等场景。存内处理在芯片制造过程中将“存”与“算”集成于同一晶粒(Die),使存储器本身具备一定算力,业内方案多在DRAM芯片中加入算力,典型产品形态为三星HBM-PIM与PIM-DIMM。存内计算不再区分存储单元与计算单元,直接消除“存”“算”界限,将AI深度学习中的乘累加运算直接映射到存储结构中完成,具有高能效比与低延迟,主要服务AI计算场景。
浪潮信息在存算融合方向的布局已从系统级优化起步,本次定增拟进一步将相关技术研发推向深化。1)现有储备方面,公司技术体系已涵盖数据存储与存算融合方向,并围绕KV-Cache卸载、长上下文推理加速、多智能体协作调度三个关键方向完成核心技术储备与架构预研:通过网络实现显存数据的无损卸载与极速回读,可支持百万级Token超长上下文窗口、降低单次推理成本;自研BIOS/BMC面向Agent动态负载进行底层调度优化;下一代高速互联技术完成预研布局,用于缓解Agent高频交互中的通信瓶颈。2)募投目标方面,多智能体协同存算融合算力基础设施关键技术研发项目拟使用募集资金14亿元(总投资20.59亿元,建设期3年),沿三条路径推进:建设国产GPU生态适配中心,开展面向存算融合的数据基础设施研发,以及下一代Agent服务器关键基础设施算存研发,重点攻克Agent“记忆系统”的效率难题、解决Agent时代训练推理阶段的存储瓶颈。
1.4 投资建议
2.行业新闻
60亿元投资平台落地,无锡加码半导体扩产
无锡锡虹国芯二期投资有限公司成立,注册资本60亿元,由无锡国联实业投资集团有限公司、无锡产业发展集团有限公司等共同持股。根据华虹宏力披露的增资方案,这家新公司拟出资8.34亿美元,持有无锡华虹宏力三期半导体有限公司20%股权,参与建设月产能约5.5万片的12英寸特色工艺晶圆代工产线。
长三角科学数据共享服务平台启动共建
在2026浦江创新论坛上,长三角科学数据共享服务平台启动共建。今年6月,上海市与江苏、浙江、安徽三省共同签署《共建长三角科学数据共享服务平台的框架协议》,而在开幕式上,平台建设正式启动。该平台将汇聚三省一市科技数据资源,为上海(长三角)科技创新中心建设贡献强大的数据力量,让科学数据在区域内自由流动、高效利用。
中国算力平台实现全国一体化算力统筹监测
3.公司新闻
浪潮信息:2026年度向特定对象发行A股股票预案
2026年9月11日,浪潮信息发布公告,公司拟定增募资不超过90亿元(含本数),扣除发行费用后的募集资金净额将用于面向智能体规模化应用的新一代AI基础设施研发及产业化项目、面向绿色智算集群的液冷原生算力基础设施研发及产业化项目、多智能体协同存算融合算力基础设施关键技术研发项目、高密度算力装备智造与交付能力升级工程并补充流动资金。
海量数据:关于2026年度向特定对象发行A股股票的申请获得上海证券交易所审核通过的公告
北京海量数据技术股份有限公司于近日收到上海证券交易所出具的《关于北京海量数据技术股份有限公司向特定对象发行股票的交易所审核意见》,具体意见如下:“北京海量数据技术股份有限公司向特定对象发行股票申请符合发行条件、上市条件和信息披露要求。本所将在收到你公司申请文件后提交中国证监会注册。”
中科创达:关于子公司与专业机构共同投资的进展公告
4.本周市场回顾
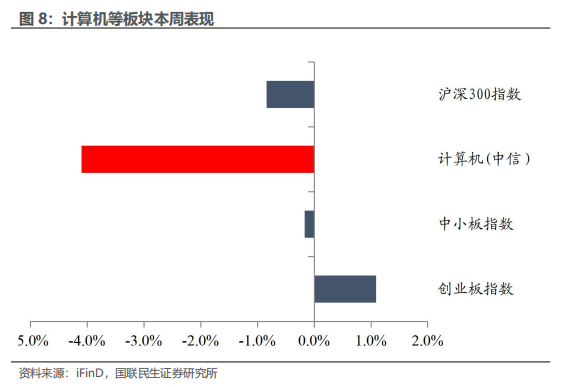
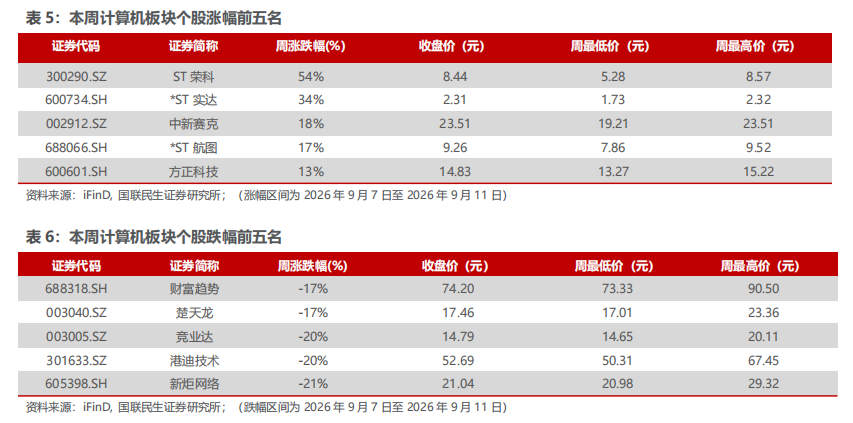
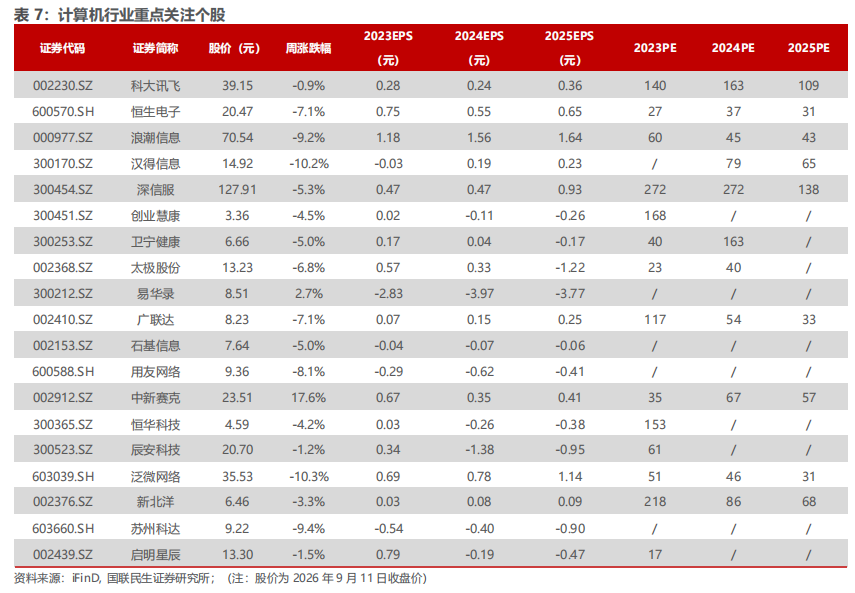
本周(09.7-09.11)沪深300指数下跌0.83%,中小板指数下跌0.16%,创业板指数上涨1.08%,计算机(中信)板块下跌4.09%。板块个股涨幅前五名分别为:ST荣科、*ST实达、中新赛克、*ST航图、方正科技;跌幅前五名分别为:新炬网络、港迪技术、竞业达、楚天龙、财富趋势。

 VIP复盘网
