

9月10日,外滩大会现场,生数科技联合创始人、CEO骆怡航正式发布了一个新模型——Motus2,面向机器人灵巧操作的自进化通用世界模型。
如果你对具身智能稍有了解,应该知道“世界模型”这个词最近有多火。但Motus2想做的事,比单纯“预测未来”更进一步:
机器人不仅要会做,还要知道做了之后会发生什么、结果好不好,并且从结果里继续学习。
翻译一下就是:以前的机器人是“你教它怎么做”,现在的Motus2开始尝试“它自己教自己”。
01.
一场没有边界的混战
具身世界模型正逐渐成为一个拥挤的赛道。
目前,国内公开宣称在做“世界模型”的公司超过55家,12家已进入独角兽行列。仅上半年,具身智能赛道披露融资额就超过460亿元,七成砸向前20家公司。Google Trends上,“world model”全球搜索热度同比暴涨1200%。但赛道内部已分化为多条技术路线,每一派都在用自己的方式定义“世界模型”应该是什么。
但热潮之下,还有一个值得注意的问题是:大多数世界模型在“物理遵循性”和“可控性”上的表现,远远落后于它们生成逼真画面的能力。2026年CVPR设立的WorldArena Track1评测,从视觉质量、运动质量、内容一致性、物理遵循性、3D空间准确性和可控性等维度综合评测世界模型,结果毫不意外地暴露出一个断层——模型能生成以假乱真的未来画面,却很难保证那个未来在物理上是可执行的。
这正是上半场的核心矛盾:所有人都在卷“预测未来”,但预测得准,不等于用得好。
无论是走端侧实时路线的,还是融合VLA与世界模型的,抑或从推理效率切入的,大家回答的基本是同一个问题:给定当前状态和动作,世界接下来会变成什么样?
这是一个“预测问题”。而预测之后呢?结果好不好?距离任务目标更近了还是更远了?
行业没有能系统性地回答这个问题。
02.
一道被忽略的断层:从“预测”到“评估”
传统策略模型只回答“下一步做什么”。加了世界模型之后,机器人可以回答“做完会怎样”。但这两个问题之间,缺了一路能力:对结果本身的评估。
没有这一路,“预测”就只是信息增益,无法转化为策略改进信号。模型可以生成100种可能的未来,但不知道哪一种值得追求。
Motus2想补上的,正是Evaluation和Feedback。它试图把世界模型的闭环从“行动→预测”推进到:
行动→预测→评估→反馈→再学习
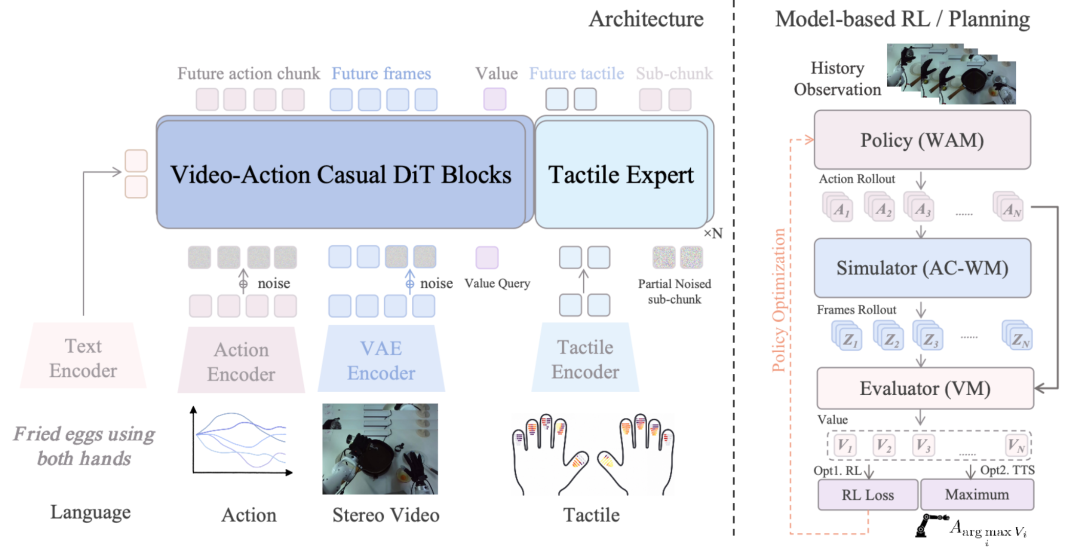
Motus2的做法,是把行动、预测、评估三种能力塞进同一个视频—动作模型里。行动回答“下一步做什么”,预测回答“做完会怎样”,评估回答“这个结果好不好”。三者不是外挂关系,而是同一个模型的三路输出。
动作只读取执行前已有的信息,未来预测可以读取动作,评估可以同时读取动作和预测结果。这种信息流设计首先是为了防止训练时动作提前看到未来信息而作弊,同时让部署时可根据场景灵活调用——简单任务只跑动作生成,复杂任务再启动完整的“生成-预测-评估”链条。
但架构层面的统一只是前提。真正的突破发生在闭环形成之后。
03.
闭环自进化,世界模型开始“自己训练自己”
Motus2的闭环在两个阶段分别发挥作用。
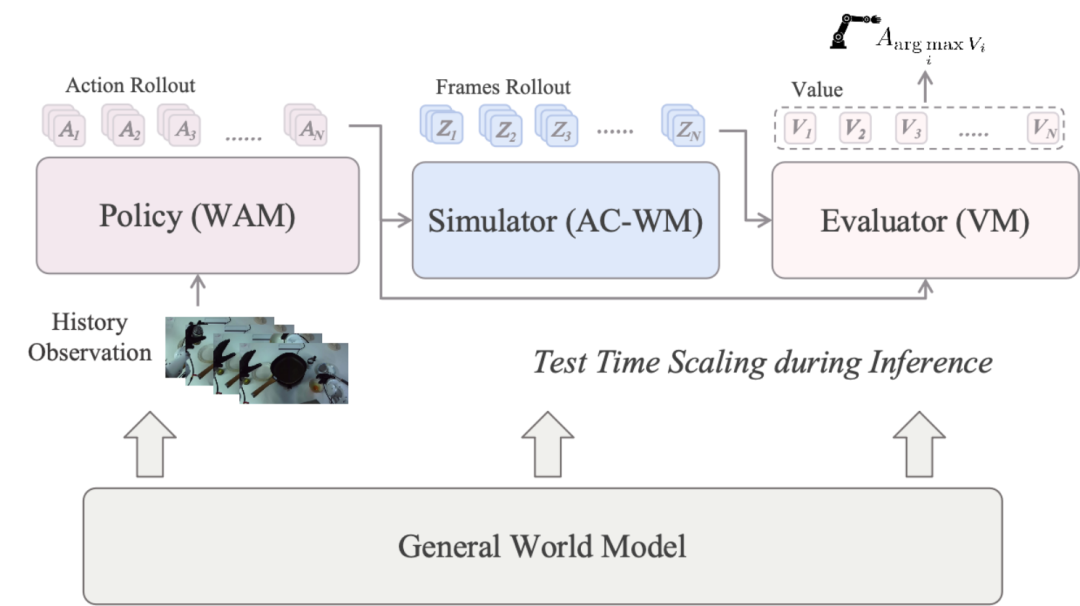
推理阶段,模型不会只生成一个动作方案,而是生成多个候选动作,分别预测每个方案的执行结果,再由评估模块打分排序,选择得分最高的方案执行。完成一个动作片段后,机器人重新观测真实世界状态,开启下一轮规划。简单说,就是让机器人“多想几步,挑最靠谱的做”。
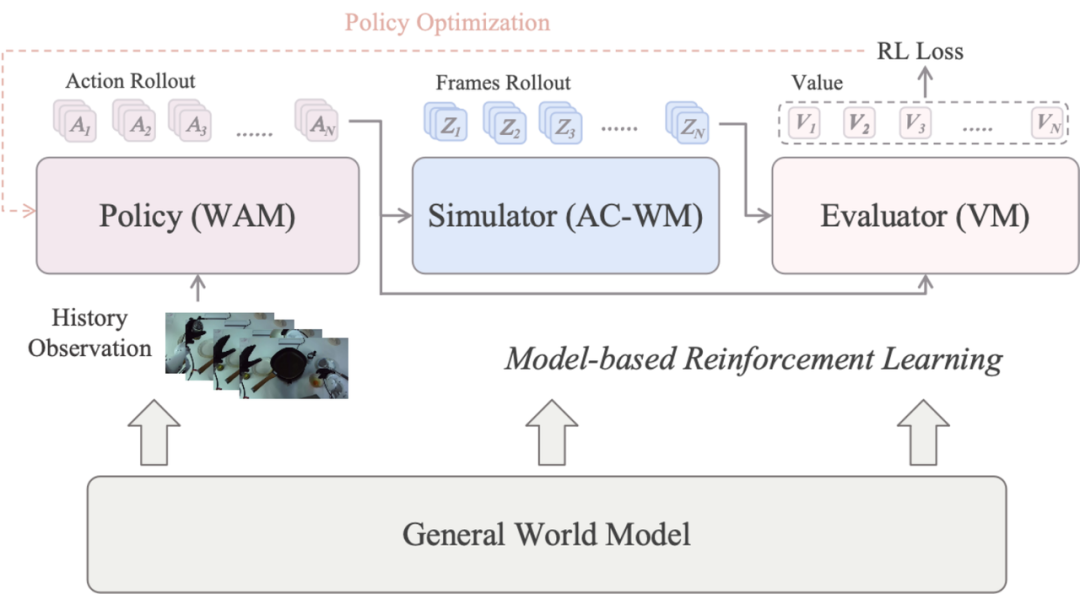
训练阶段,候选动作的评估分数直接转化为策略更新信号:高价值方案得到正向强化,低价值方案被逐步弱化。模型自己预测出来的未来,开始成为训练自己的教材。
换句话说,模型自己预测出来的未来,开始成为训练自己的教材。
这彻底改变了机器人数据的使用逻辑。过去机器人学习动作,主要依靠成功的示范数据告诉它“应该怎么做”;失败数据大多被当作噪声过滤掉。但在Motus2的闭环里,失败与次优轨迹反而具备独特价值——它能帮模型理解“做了什么、世界发生了什么、为什么没达成目标”。
数据是最直观的证明:在放置手机与多指操作两项任务中,Motus2基础策略的平均成功率为65%;加入规划后提升至67.5%;加入MBRL后达到72.5%;两者同时启用时最终达到75%,相比基础策略提升了10个百分点。
04.
数据与感知的双重补全
但自进化不是空中楼阁,它需要两个基础:足够的世界常识打底,完整的状态信息输入。
在数据层面,Motus2走出了一条“人类经验规模化迁移+机器人小样本适配”的路径,破解了机器人数据成本过高、难以规模化的行业痛点。
它用约13万小时的第一人称人类操作视频做预训练,先让模型学习通用的物体规律、场景逻辑与操作常识。这些低成本的人类日常交互数据,为模型打下了宽泛的世界认知基础。在此之上,仅用百小时级的机器人轨迹与人机对齐数据做领域适配,就把人类的操作经验迁移到了机器人的身体控制空间。
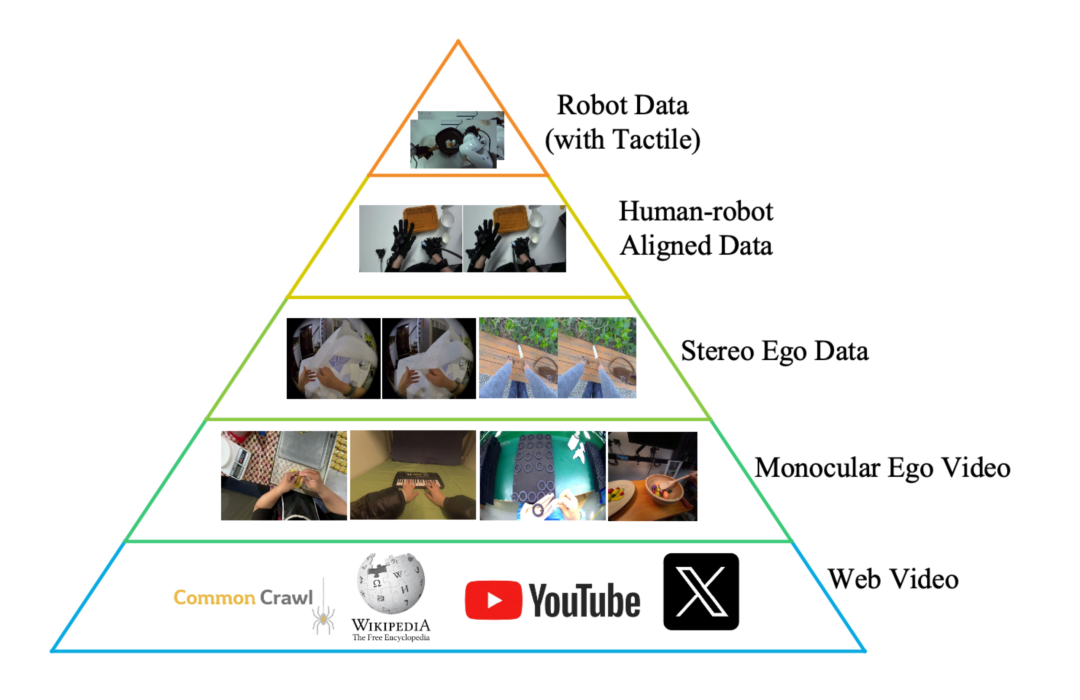
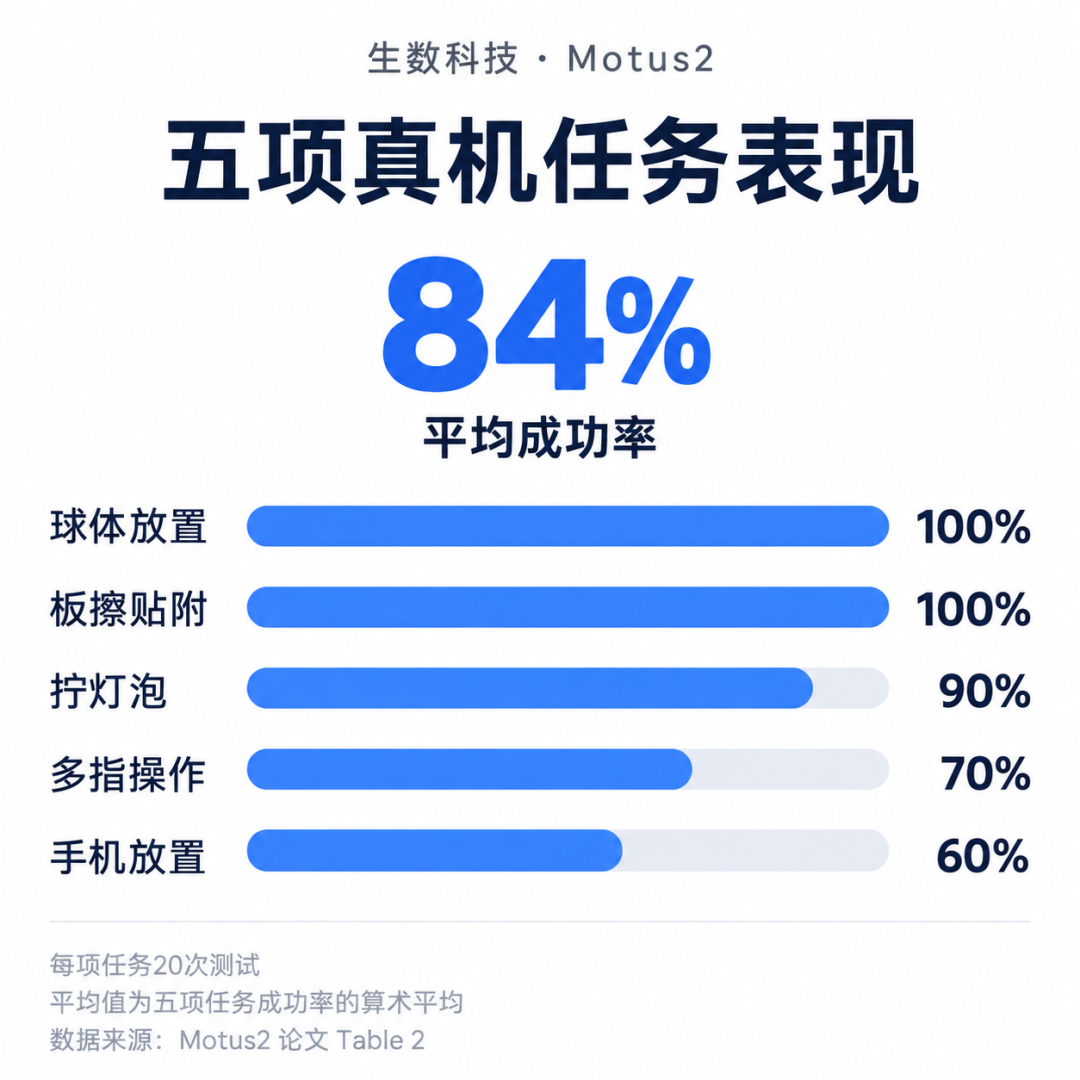
这种分层数据思路的效率很高:仅经过人类数据预训练的模型,真机任务成功率就能达到51%;加入百小时级机器人适配训练后,五项核心任务的平均成功率直接跃升至84%。人类数据负责铺规模,机器人数据负责精准落地,各自发挥优势,避开了纯靠机器人数据堆能力的高成本陷阱。
在感知层面,Motus2用记忆与触觉补全了单帧视觉的盲区,让评估与反馈有了更准确的输入依据。
真实世界的操作从来不只依赖当下画面。目标被遮挡、位置被移动,就需要记忆此前的观测;接触中的力度变化、滑动偏移,就需要触觉反馈补充视觉看不到的接触状态。Motus2分别通过长时信息机制保留历史观测,通过轻量级触觉模块实时感知接触变化,让机器人对状态的判断从“单帧画面”变成了“连续的、有接触的完整体验”。
这两块支撑共同回答了一个问题:为什么自进化的闭环能在Motus2上跑通,足够的常识基础让评估有参照,完整的感知信息让判断更准确。
05.
结语
放在生数科技提出的GWM通用世界模型五级路线里看,Motus2的定位非常清晰:它是L3「在世界中行动」向L4「自主世界智能体」迈进的一次初步尝试。
L3阶段的核心是模型理解环境、预测变化、输出动作,本质上还是更智能的执行器。而L4阶段的核心是“能自主进化”:模型可以评判自身行动的结果,可以从经验中持续优化策略,进化的主导者从人类变成模型自己。
从这个标准看,Motus2目前的自进化还集中在多任务的策略优化层面,开放世界的长期自主学习、跨任务的能力迁移、更长时间尺度的记忆与迭代,都还有很长的路要走。但它的价值在于,第一次把“评估-反馈-进化”的完整逻辑,在真实物理机器人上验证跑通了。
在此之前,自进化更多是行业的愿景和概念;在此之后,它变成了一条可以落地、可以验证、可以持续迭代的具体路径。
对于整个具身智能行业而言,这同样是一个值得注意的信号。过去几年大家比拼的是演示数量、动作流畅度、模态丰富度,本质上都是在L3维度上的内卷。而Motus2推开了另一扇门:下一代的竞争,将会围绕“进化效率”展开,谁能更少依赖人工,谁能更快从经验中迭代,谁就能走得更远。
从“会做事”到“会从做事里学得更好”,这一步很小,却足够关键。Motus2站在了这条新赛道的起点,而整个具身世界模型的下半场,也正由此开启。

 VIP复盘网
